
两台设备一起算,答案从 Paris 变成了 Rome|distributed-llama 我编译真跑了一遍
一台设备的内存墙,我想绕过去
上个月有个朋友找我出主意。他手里攒了几台吃灰的旧设备:一台 M1 Mac mini、两台小主机、还有一块树莓派,想把一个 70B 级别的模型搬回家自己跑,不想按月给云端交钱。我给他算了算账,卡点特别清楚:70B 模型就算压到 Q4 量化,权重也得 40GB 上下,他任何一台设备的内存都装不下。他把三台设备的内存加起来问我「总和够了呀,能不能拼一拼」,这句话正好问在了点上——内存拼得起来,算力拼不起来,这正是分布式推理最难啃的那块骨头。
老办法就两条路。第一条,砸钱换一台大内存机器,64GB 的 Mac 至少小两万,为了跑个模型太奢侈。第二条,用 llama.cpp 的 RPC 模式把模型按层拆到多台设备上,各节点轮流干活——这个思路能跑,但按层接力意味着第一个节点算完第一层才轮到第二个节点,网络来回次数跟着层数走,速度感人。后来 Jeff Geerling 在他那个树莓派集群项目里实测,llama.cpp RPC 跑 70B 每秒只出 0.28 个 token,慢到基本没法看(出处见后文)。
我当时还有个想法:用推理服务器把几台设备当一个池子调度,请求轮流分发到不同机器。这条路更不行——它解决的是「很多人同时用」的问题,解决不了「一个模型装不下」的问题,单个请求还是得完整塞进一台设备的内存里。
就在我劝他死心的时候,我把 distributed-llama 这个仓库翻了出来。它跟 llama.cpp RPC 走的是完全不同的切法:不是按层接力,而是张量并行——所有节点同时参与每一步计算,靠高速同步换速度。仓库首页一句话很戳人:「把家里的设备连成集群来加速推理,设备越多越快」。这话到底有几成是真的,我决定亲手编一遍、跑一遍再说。
它怎么把一个模型切到几台机器上
先把架构说透,因为它的代价全藏在这里。
distributed-llama 把网络里的设备分成两种角色。根节点(root)负责加载模型和权重,把权重切片分发给各个工人节点(worker),同时维护全网状态同步;每个工人节点——包括根节点自己——都握有神经网络的一块切片,每一步推理大家各算各的那一份,算完再同步。根节点的内存占用会比工人多一点,工人节点不需要任何模型配置,拿到 IP 就能上岗。
这个设计的收益和代价是绑死的。收益:模型内存按节点数摊薄,一台装不下的模型,四台凑一凑就装下了。代价:每生成一个 token,所有节点都要同步一轮。我在两节点实测里盯着日志算过,每个 token 要发 63kB、收 356kB 数据,同步耗时 2 到 8 毫秒——这还是本机 loopback 的成绩,换成千兆网线只会更糟。也就是说,它的天花板大概率不是 CPU 算力,而是网线。
跟 llama.cpp RPC 摆在一起看会更清楚。RPC 是流水线:每个节点扛若干层,数据像接力棒一样一棒一棒传,网络流量跟模型层数成正比,某个慢节点会成为全链路的节拍器。distributed-llama 是合唱:每层内部切开大家一起算,算完一次全归约,同步次数跟层数无关、只跟生成步数成正比。这就是为什么它在同构、低延迟、有线互联的场景下能跑出 RPC 拿不到的速度,也解释了为什么到了 Wi-Fi 或者配置不齐的设备上它就水土不服——合唱队里只要一个人慢半拍,所有人都得等他。
还有三条硬限制,动工之前必须先背下来:
- 节点数只能是 2 的幂:1、2、4、8。你有三台设备,就只能用两台,剩下一台干看着。这个约束来自张量并行的切分算法,不是拍脑袋定的,但对你家设备清单是实打实的约束。
- 节点数上限等于模型的 KV head 数量(issue #70)。大多数稠密模型 KV head 够多,问题不大;个别 MoE 模型这个数会很低,天花板一下就压下来了。
- 量化只支持两种组合(issue #183):q40 权重配 q80 同步缓冲,或者全程 f32。GGUF 那一套各种量化在这儿通通不认。q80 缓冲是它的折中术:权重压到 4 比特省内存,同步时升到 8 比特保精度,两边各让一步。
另外有个实用参数值得记住:--max-seq-len。把最大序列长度从默认值压到你真正需要的数(比如 2048),KV cache 的内存跟着缩,对内存刚好卡线的节点是救命稻草。
最后一条容易被忽略:它不能直接吃 GGUF。模型得转换成自家 .m 格式,作者在 Hugging Face 上放了预转换好的模型仓库,或者自己用仓库里的 convert-hf.py 转——大模型转换要几小时外加双份磁盘空间,405B 模型光下载就要 238GB,转换期间你得备出约 1.1TB 的空地。
哪些是真本事,哪些还欠着火候
我把它的能力按「信不信得过」分了三档。
信得过的:CPU 路径。ARM 和 x86 AVX2 都做了优化,Linux、macOS、Windows 全支持,编译就一个 make。Windows 走 Chocolatey 装 mingw 就能编,树莓派文档专门写了要装 64 位的 Lite 系统(不带桌面的那个)。模型下载有 launch.py 一条命令,预转换模型列表覆盖 Llama 3.1/3.2/3.3(最大到 405B)、DeepSeek R1 蒸馏版、Qwen3 全系(0.6B 到 30B MoE),两天前刚发的 v0.17.0 又加了 Qwen3.5 9B——编译时我亲眼看到 qwen35-graph.cpp 出现在编译输出里,新功能是真的进了主代码。API 服务 dllama-api 提供 OpenAI 兼容端点,/v1/models 和 /v1/chat/completions 我都拿 curl 打过,能正常返回。仓库的 discussions 区还是个宝藏,作者把各地用户提交的实测配置都汇总在那儿,我后面引用的 Mac Mini 数据就来自官方置顶的帖子。
要打折扣的:GPU 路径。Vulkan 后端从 2025 年 3 月的 v0.13.0 进来,至今标着实验性,issue #50「Vulkan Acceleration」挂着 35 条评论快两年没收口。更扎心的是 issue #265,有人实测 Qwen 8B 上 GPU 反而比 CPU 慢,标题就叫「Unexpected Performance」;issue #272 里 AMD GPU 跑 70B 干脆没输出。我的判断:GPU 加速这条路现在只能算「在铺」,想用 GPU 节点组集群的,先把这两个 issue 看完再决定。
还没有的:embedding 接口(feature 请求 #96 挂着)、手机节点(#89 有人在问,没下文)。想要的话现在只能等。
编译安装比我想的顺利,坑全在模型那边
我在 M2 的 MacBook 上完整走了一遍,全程顺利得有点意外。
git clone https://github.com/b4rtaz/distributed-llama.git
cd distributed-llama
make dllama
make dllama-api
make 用 g++ -O3 编译,我这台机器 30 秒内编完,产物是两个二进制:dllama 和 dllama-api,加起来不到 1MB。没有 Python 依赖,没有巨型运行时,这一点比很多同类项目体面得多。
模型下载用仓库自带的 launch.py(需要 Python 3):
python3 launch.py                # 打印可用模型列表
python3 launch.py qwen3_0.6b_q40 # 下载 0.9GB 的 Qwen3 0.6B
下载完它会顺手生成一个 run_qwen3_0.6b_q40.sh,命令参数都替你拼好了。多节点部署时,模型只需要下载到根节点,工人节点空手起步——这个细节对树莓派用户很友好,4GB 的卡不用腾地方放权重。
多节点的组网流程官方文档写得细,树莓派那篇的关键几步是:每台设备装 64 位系统、接网线到同一个交换机(两台设备可以直连省掉交换机)、给每台设备配静态 IP(sudo ip addr add 10.0.0.2/24 dev eth0 这种一行命令)、所有设备编译同一份代码,然后工人在各自机器上起服务,根节点启动时把工人地址用空格串在 --workers 参数后面。工人节点那条命令官方写的是 sudo nice -n -20,意思是把调度优先级拉满——同步是实时性敏感操作,这条后面还会再提。
官方文档没写整机最低配置表,这话我先说在前头。我按两处官方口径推了两档:一是 README 的模型体积表(内存占用按节点数摊薄,根节点略多),二是树莓派文档明确要求 64 位系统。
- 最低可用档:2 台 8GB 内存的 64 位设备,千兆网线直连,跑 0.6B 到 3B 验证链路没问题。这是按模型体积表推的,不是官方数字。
- 建议档:4 台 24GB 内存、万兆或雷电互联。这不是我拍脑袋——官方 README 引用的实测帖(discussion #147)就是 4 台 Mac Mini M4 Pro 24GB 雷电 5 互联跑 Llama 3.3 70B,每秒 6.51 个 token,2 台时是 3.31,同样配置走 10G 网线是 6.04。磁盘方面,从 0.9GB(0.6B)到 238GB(405B)按模型表对号入座。
我跑出来的四个数字
装完我就想验证两件事:单机性能到底什么水平,拆成两台到底是加速还是拖累。
第一个数字,单节点 Qwen3 0.6B Q40,8 线程:
Evaluation    tokens/s: 122.10 (8.19 ms/tok)
Prediction    tokens/s: 77.05 (12.98 ms/tok)
输出「The capital of France is Paris.」,答案正确。顺便撞出一个反常识的发现:我把线程数降到 4,预测速度反而冲到 165.31 tok/s,比 8 线程快了一倍还多。我这颗 M2 是 4 性能核 + 4 能效核的异构布局,8 线程把任务摊到能效核上反而拖后腿。在 Mac 上跑的朋友,--nthreads 先填物理性能核数试试。
第二个数字,本机再起一个 worker 组成两节点:
Prediction tokens/s: 44.26
Pred 8 ms Sync 6 ms | Sent 63 kB Recv 356 kB
同一台机器上拆两个节点,速度从 165 掉到 44——本机测试只能证明功能通了,证明不了加速。真正的收益要看 discussion #147 那种真实集群:70B 从单机装不下,到 2 台 3.31、4 台 6.51,翻倍关系基本成立。
第三个数字最有意思。单节点输出「Paris」,两节点跑同一个 prompt、同样的贪心解码,输出变成了「Rome」。权重切片重排之后浮点累加顺序变了,数值漂移把 argmax 顶翻了一个位置。这不是我手抖,后面翻社区帖子时发现 Jeff Geerling 在大规模集群上报告过「生成的 token 有时是乱码」,跟我在 loopback 上撞到的是同一类问题的轻重两档。分布式切分会改变输出质量,这件事 README 里一个字没提,我建议官方写进文档。
第四个,API 服务验证:
curl http://127.0.0.1:9999/v1/models
# {"data":[{"id":"dllama_model_qwen3_0.6b_q40.m","object":"model",...}]}
curl http://127.0.0.1:9999/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"用一句话介绍杭州"}]}'
# 正常返回,Qwen3 的 <think> 推理流也能出
接 OpenAI SDK 写的下游应用基本可以无痛换基座。不过 finish_reason 字段返回的是空串,做严格的流式收尾判断时要留个心眼。另外提醒一句:聊天模式 dllama chat 是给命令行准备的,token 一个个往外蹦的体验很直观,适合先拿它确认模型行为,再切到 API 模式接工具链。
四个数字放在一起,结论其实已经浮出来了:单机性能是合格的,多节点内存摊薄是真的,但「设备越多越快」这句宣传语得打个补丁——同构设备、有线互联、模型大到单机装不下,三个条件同时满足时它才兑现承诺,缺一条都可能越拆越慢,甚至把答案算歪。
翻完 issue 和社区帖子,我归纳出五条坑
仓库开放 issue 只有 48 个,不算热闹,但评论区质量意外地高,加上第三方实测帖,能拼出一张完整的避坑图:
- 加节点不一定线性加速,甚至可能倒退。issue #20 里有人从 4 台树莓派扩到 8 台,同步时间突然暴涨,高赞讨论了很久;issue #179 在 12 代 NUC 上跑 8B 看不到扩展收益。第三方汇总(SpecPicks 2026 年的分析文)给的规律是:4 节点约摸 2 倍速度、8 节点约摸 3 倍,千兆以太网在 8 节点以上就成墙了。
- 别拿它跟正经硬件拼性价比。Geerling 在10 节点树莓派 5 集群的基准记录里写得很直白:70B 模型 8 节点跑到 0.85 tok/s,比用 Vulkan 加速的 x86 集群慢 5 倍,还偶尔吐乱码。他的结论是三千美元的树莓派集群不划算——这笔账对想新买设备组集群的人同样成立。
- 模型转换是隐形工程。issue #185:Mistral Large 的 tokenizer 转不过去,报「Cannot resolve bosId or eosIds」。官方预转换仓库没覆盖的模型,你得自己过
convert-hf.py这道坎,报错了没人替你兜。 - 工人节点要提权调度。树莓派文档里写的是
sudo nice -n -20 ./dllama worker——同步是实时性敏感操作,普通优先级下别的进程一抢时间片,整条流水线跟着抖。这条很多人会漏。 - 也有顺利的正例。Seeed Studio 官方 wiki 有篇部署记录:1 台 8GB 树莓派当根节点带 3 台 4GB 工人节点跑 DeepSeek 8B,实测 6.06 tok/s。4GB 的卡能当工人用,说明内存摊薄的机制是真的在工作。
我最后的判断
值不值得上手,我按人分。
该上手的人:手里已经躺着 2 台或 4 台同构设备、内存加起来装得下你想跑的模型、愿意拿一下午换一个「大模型在我自己设备上跑起来」的体验——这个项目的完成度对得起你的半天时间,CPU 路径开箱即用,编译 30 秒,API 还能直接接现有工具链。
别碰的人:想为新硬件组集群的——同样的钱买一台 32GB 二手 mini 主机,速度大概率更快、还不折腾,SpecPicks 的对比表算得很清楚;要给生产环境供 API 的——finish_reason 空串、两节点的答案漂移、GPU 路径未成熟,这三条任何一条都够你头疼;想混搭异构设备的——张量并行对节点间带宽太敏感,笔记本 Wi-Fi 就别想了。
替代方案我点名两个。llama.cpp RPC:按层切分,直接吃 GGUF,支持异构节点,生态成熟得多;代价是 Geerling 实测的极端慢速(0.28 tok/s 对 0.85)和更高的网络来回次数。exo:野心更大、接口更花哨,但 Geerling 在 2 到 3 节点的小集群上连 3B 模型都没跑起来,我现在不敢把它列成正经选项。两个维度摆在这:要灵活和生态选 llama.cpp RPC,要速度和内存摊薄选 distributed-llama,不存在两头都占的。
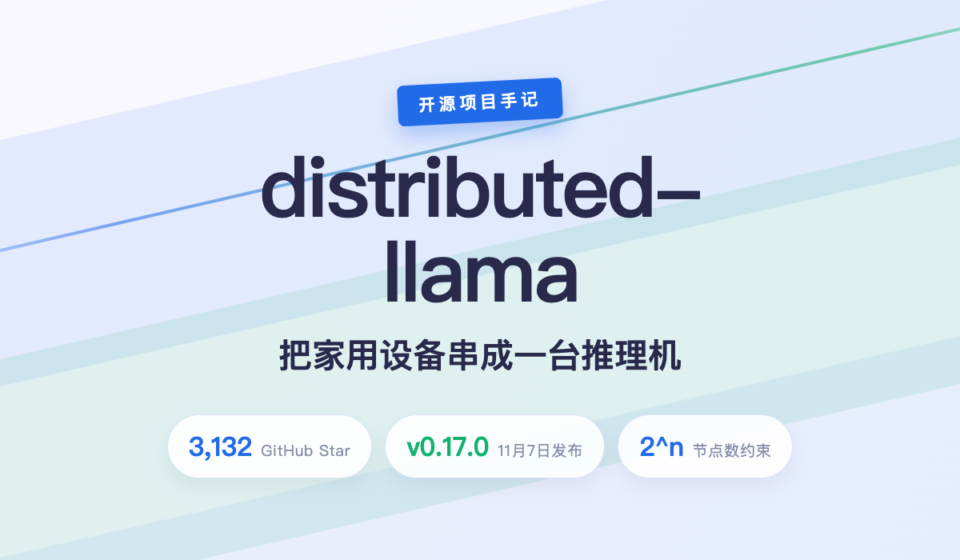
一句话收尾:总而言之,distributed-llama 用最朴素的 C++ 和 TCP 把「家用设备组推理集群」这件事做到了能用的程度,我顺手拉了下,现在是 3,132 个 star,v0.17.0 两天前刚加上 Qwen3.5 支持,最近四周 11 次提交——节奏不快,但每个发版都有真东西。最后说句实在的,它救不了想白嫖 70B 的人,但能让你家吃灰的旧设备第一次为跑大模型出上力;至于那个 Paris 变 Rome 的小惊喜,就当是分布式系统送给较真用户的见面礼吧。