
外语视频搬成中文成片,我以前要串五个工具|OpenCreator 我还没装,坑先替你翻了一遍
一条视频的五道工序,五把刀
先说一个我自己经历过好几轮的场景。团队做了一场线上分享,四十多分钟的录屏想搬成对外的教程视频:先把音频扒下来转成文字,再一段一段翻译,翻译完逐句对时间轴,然后找人配音,最后还得按发布平台重排一遍——横屏一版、竖屏一版。这套活我以前拆给过四个工具加一台人肉对轴:下载器、转写工具、翻译脚本、剪映,中间每一步导出再导入,光是把 SRT 文件倒来倒去就够磨人的,断句断得稀碎还得手工修。
后来断断续续试过一些”一条龙”工具,大部分只做到字幕就停了,配音和竖屏排版还是得自己接。直到我把 krillinai/OpenCreator 这个仓库翻了一遍,才发现它把整条流水线——下载、转写、翻译、配音、横竖屏重排、封面,全部装进了一个应用里。它的前身叫 KrillinAI,视频翻译配音这个环节在社区里已经磨了快两年,现在改名叫 OpenCreator,往更大的创作者工作台方向走。
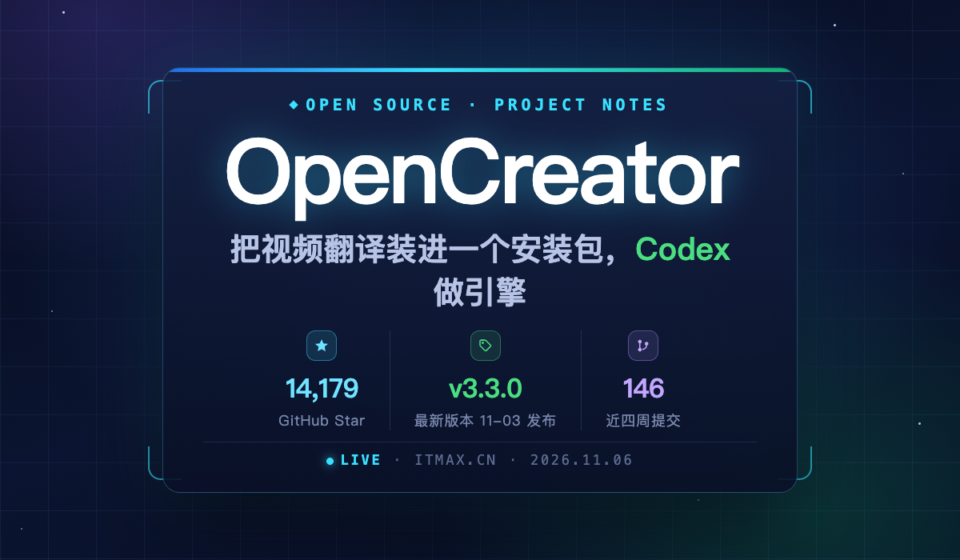
丑话说在前面:这次我没有把它装起来跑成片。它是个 Electron 桌面应用,真实跑任务需要能用的 ChatGPT 登录态或 API key,我手上没有现成的额度,所以这一篇的结论来自官方 README、发布日志、仓库里的 CLI 契约文档、一百五十条上下的 issue,以及几篇第三方拆解文的交叉核对。数字全是今天从仓库实时拉的:14,179 个 star,v3.3.0 在 11 月 3 日发布,最近四周 146 次提交。
十个工具面板,值钱的是哪一个
按 README 的功能矩阵,现在有十个创作者工具上线,两个还在开发中。我把它们按成色分了三档,这是我的判断,不是官方口径。
第一档,真正值钱的是视频翻译。这是它的老本行,也是唯一经受过长期实战的链路:导入本地视频或公开链接,用云端 Whisper 或本地 faster-whisper、whisper.cpp、WhisperKit 转写,大模型负责字幕分段、对齐、术语统一和翻译,支持双语字幕、配音、自定义音色样本,最后按横屏或竖屏导出 SRT、音频或成片。README 给的语言目录是 123 种源语言、124 种目标语言(含拼音输出),官方也诚实标注了语言目录不等于每个模型都支持每种语言。仓库自带的公开案例里有一段 46 分钟的本地视频,一次跑完字幕全程没有人工调整,这个数字我核对了案例出处,是改名前 KrillinAI 时期放出来的。
第二档,能用但本质是接 API 的壳。图片生成(GPT Image、Seedream、Kling、Gemini)、视频生成(Seedance、Kling、Veo)、智能配音、封面生成,都是把各家服务的调用包装成统一面板,配了比例、分辨率、时长这些常规控件。用起来顺手,但没有任何本地推理的成分,成片质量完全取决于你接了哪家的模型——它自己不造模型,这是一条总装线。
第一档里还有两个容易被忽略的实用件值得单独说。视频下载器覆盖 YouTube、B 站、X、TikTok、Instagram、抖音、Facebook、小红书、Pinterest、Reddit 十个平台的公开视频,会先解析可用格式再让你挑分辨率和音轨下载,部分来源需要平台 cookie,能抓到平台字幕时还能直接把 SRT 一起拿走——对做搬运的人来说,这一步就已经省掉一个独立工具。字幕编辑器是沉浸式的:原文译文左右对照、视频预览和波形时间轴联动,支持逐句拆分合并、查找替换、样式实时预览,改完直接出新一版。配套的模板库里,官方和第三方创作者把调好的提示词和参数做成可复用模板,选一个改改输入就能开工,不用每次从零写提示词。
另外有两处产品细节我看着觉得挺扎实:每一版产出都是独立版本,配音换一版、字幕样式换一版都不会互相覆盖,回头对比很省心;界面做了 43 种语言,连阿拉伯语、波斯语这类从右往左的排版都专门处理了,字幕渲染还内置了兜底字体,避免复杂文字在成片里变成方框。
第三档,看看就好。火柴人动画带着和插画师合作的预设角色,玩法新鲜但内容生态刚起步;智能切片和数字人在 README 里明确标着 In development,还没上线。
命令行走 CLI 的话,仓库里的技能文档把每个阶段的命令、参数、输出文件写得非常死,我逐段核对过,这是它对自动化最友好的部分——每一步独立执行、产出结构化中间文件,可以只重跑某一段。
不自己写引擎,是把双刃剑
OpenCreator 架构上最特别的决定是:它没有自己实现执行循环,而是直接把 Codex CLI 当成执行引擎,外面包了一层本地 Runtime(Fastify + SSE)、可视化工作区和 Electron 桌面壳,任务状态、审批、附件、Skills、MCP、定时任务都挂在 Runtime 上,持久化用 SQLite 和本地文件系统,守护进程只监听回环地址。
我觉得这个决定聪明在于省掉了最难维护的那块。执行循环、工具调用、会话管理、模型目录这些东西 Codex 已经做完了,自己再造一遍只会落后半拍。模型目录甚至是带日期版本号的(仓库里能看到 model-catalog-2026-08-05.ts 这样的文件),说明它在认真管理上游变化。
但代价也得说透:故障面变大了。Codex 认证、转写模型、平台下载、TTS 服务商、渲染组件,五层依赖任何一层出问题,整条链就断在你面前。官方排障文档里专门列了 RUNTIME_START_FAILED、RUNTIME_PROXY_FAILED、401 token_expired 这类错误码,说明维护者自己也清楚这个痛点。另外想完全零成本离线跑是不成立的——转写可以走本地 faster-whisper,但翻译和配音默认都要接云端服务,第三方有一篇点评(aiidelist)把这层关系讲得很直白:开源的是应用本身,不是模型的使用权。
还有一层代价容易被忽视:绑定 Codex 生态的深度比想象中高。Skills 和 MCP 管理都是透传 Codex 原生的配置和命令,默认读写你当前激活的 CODEX_HOME——官方文档里专门提醒,改全局 Skills 或 MCP 配置前要想清楚影响范围。如果你本来就在用 Codex,这是无缝复用;如果你的执行引擎在其他生态里,迁过来的成本不低。所有对话按项目归档、任务后台排队执行、每个定时任务绑定专属会话串行跑,这套编排对长流水线很友好,但也都建立在它自己的状态机之上,想半路换引擎,迁移是整建的。
我的立场是认可这个取舍的。总装线逻辑下,它把最脏的活(下载、对轴、重排、多版本管理)做扎实了,模型质量你自己选,这比把一个平庸模型焊死在工具里强。
装它有三条路,门槛各不相同
路线一,桌面安装包,最省事。GitHub Releases 直接下:macOS Apple Silicon、macOS Intel、Windows x64 三种,Codex CLI 已经打包在内,不需要装 Node。首次启动会扫描本地已有的 Codex 配置,能复用登录态就直接确认,不能就走引导表单配其他服务商。注意两点:Windows 安装包目前没有 Authenticode 签名,官方让你先验 SHA-256;Remotion 渲染组件不随安装包分发,是按需下载的。
路线二,源码跑 Web 端,适合开发或服务器部署。要求 Node.js 22 以上、pnpm 9.15.0(版本号锁死在 package.json 的 packageManager 字段里)、终端里有可用的 Codex CLI 登录:
git clone https://github.com/krillinai/OpenCreator.git
cd OpenCreator
corepack enable
pnpm install
pnpm web:dev
起来之后开 http://127.0.0.1:19861/,开发服务器会按需拉起本地守护进程,临时 token 走同源代理注入,不用手动复制。
路线三,Server / CLI 二进制。除了三大桌面平台,还提供 Linux x64 和 ARM64 的独立二进制,想塞进服务器自动化流水线的走这条。
三选一之外还有个容易被漏掉的运维细节:yt-dlp 这个下载依赖是「托管式」管理的。应用里同时维护内置版、当前生效版、最新版三个版本,定期检查更新,更新失败时保留上一个能用的版本——这是被 yt-dlp 频繁发布逼出来的设计,好处是某个新版本坏了不至于把下载器整个带走,代价是生效版本可能悄悄落后,得自己留意要不要手动升。这个细节让我对它的工程判断多了几分信任:踩过坑才会这么设计。
硬件门槛这块要如实交代:官方没有给整机最低配置表,我没法替它编。按 Electron 应用加本地转写的常见体量,我估两档:最低 8GB 内存、双核、5GB 磁盘(转写走云端 API,本地只做调度和渲染);建议 16GB 内存、四核、10GB 磁盘(转写走本地 faster-whisper,渲染长视频时磁盘和 CPU 都吃紧)。这两档是我按应用形态和 issue 里的反馈推的,不是官方数字,仅作参考。
命令行里藏着它最硬的部分
可视化面板之外,CLI 的契约文档是我认为这个仓库含金量最高的部分。每个命令的行为、输出文件名、错误分类(usage / retryable / dependency / internal)都写成死规定。以字幕阶段为例,命令长这样:
TARGET="$(node -p "process.platform + '-' + process.arch")"
KRILLINAI_CLI=".runtime/build/krillinai/$TARGET/bin/krillinai-cli"

cd runtime/krillinai
"$KRILLINAI_CLI" subtitle "https://www.youtube.com/watch?v=VIDEO_ID" \
  --origin-lang en \
  --target-lang zh_cn \
  --workdir ../tasks/demo \
  --caption-source any \
  --prepare-video
--caption-source any 表示优先抓平台字幕、抓不到再回退转写;--prepare-video 表示把原视频准备好留给后面的渲染阶段。真跑完之后,工作目录里会出现一份 krillinai_manifest.json,后面所有阶段都从这份清单读上一步的产物,而不是猜文件名:
origin_language_srt.srt/target_language_srt.srt/bilingual_srt.srtorigin_video.mp4(要求了--prepare-video时才有)origin_audio.mp3(转写准备阶段产出)
接着一条 render-vertical --workdir ../tasks/demo 就能出竖屏成片。
也有几条边界要提前知道,都是技能文档里白纸黑字写的:pipeline 命令只支持 --dry-run 校验计划,真执行会直接返回 unsupported_command,要多阶段跑就得逐段调命令;status 是保留字没开放;voices 只列 aliyun、openai、minimax 三家的音色目录,Edge TTS 不在列;cover 只吃完整文字提示词,不接受参考图。这几条说明它的 CLI 还在快速迭代,别按想象用法硬套。
配音阶段走 tts 命令,从字幕文件出发生成目标语言配音,可选把配音直接合回视频;纯文本转语音则走 speech。每个阶段同样受 manifest 约束:跑完先查清单,清单里有有效上游产物就跳过昂贵的前置阶段,不重复烧钱。这套纪律对要长期挂自动化的人是实打实的好处——我见过太多脚本因为重跑整个流水线把 API 账单翻倍的。
再说一遍实话:上面这套命令我没有真跑,来源是仓库 skills/krillinai-cli/SKILL.md 和配套契约文档,我逐段核对过参数和输出清单,但端到端的实际体验要等我自己装机之后才能补。
那些我先替你翻过的坑
issue 区总共一百五十条上下,开着的不多,维护响应很勤。我把真正有信息量的坑按出现频率排一下:
FFmpeg 缺失直接炸,而且报错难懂。open issue 里评论最多的一条(#106,8 条评论,2025 年 4 月开到现在)就是俄语用户报 ffmpeg error: exec: no command——本机没装 FFmpeg,任务直接失败。更早的第三方拆解(夜雨聆风的那篇四项目横评)把这个坑总结成”最大的坑在启动之前”:依赖检查不过,界面都出不来。桌面版现在打包了 Codex CLI,但渲染组件仍按需下载,网络不通的环境要有心理准备。
上游模型下线,默认配置会突然失灵。#355 报了 GPT Image 1 默认模型在 10 月 23 日失效,v3.2.9 发布日志里官方确认迁移到了 gpt-image-2 并保留旧配置。这印证了我前面说的总装线特性:你接的上游动一动,你的默认设置就跟着抖。
大模型输出不规范会让解析炸掉。#291 记录了 LLM 返回文本带尾逗号导致 JSON 解析失败的问题(已修复)。这类坑在”LLM 输出直接喂下游程序”的架构里躲不掉,能修掉说明维护者在认真补,但同类问题换个服务商可能换个姿势再出现。
许可问题曾经真实存在,现在补上了。hysenlabs 的点评当时指出 README 挂着 Apache-2.0 徽章但仓库里没有 LICENSE 文件,”徽章不等于授权”。我确认过,现在仓库根目录有 LICENSE 文件,许可登记是 Apache License 2.0,当年补许可证的记录就在 #326。要商用的可以放心这一层,但记得在改动后重新核对。
任务中断后的恢复还是个短板。#191 是个功能建议:长任务跑到一半挂掉,目前没法从断点继续,只能整段重来——对 46 分钟级别的长视频任务来说,这个缺口不小,维护者还没给出排期。另外 #182 提到容器里获取视频分辨率出错,Docker 部署的要多测。翻译质量这层,v3.3.0 发布日志里专门列了一批改进:断点续翻、译文长度修复、术语一致性保护、有效译文保留——侧面说明字幕翻译在中长视频上的稳定性此前确实被打磨过很多轮。
最后避个雷:有个商业订阅站 open-creator.ai 和这个开源项目不是一回事,搜的时候别把那边的收费套餐当成这个项目的定价。
我的取舍:装,还是不装
值不值得上手,我的结论是分人。
适合上手:长期做外语内容搬运或出海分发的创作者(省掉的就是我开头那套五工具倒手的碎活);需要把视频本地化塞进自动化流水线的开发者(分阶段 CLI 和 manifest 机制就是为这个设计的);已经付费订阅了模型服务、只差一个把活串起来的人。
不建议上手:想要完全离线、零 API key 跑通全流程的——转写能本地化,翻译和配音绕不开云;只想白嫖模型算力的——开源的是流水线不是模型;对内存紧张的老机器——Electron 加渲染组件不轻。
替代方案点名两个。FunClip(MIT 协议):走 FunASR 本地转写,字幕颗粒度切得更细,纯本地不用 key,但它只管到字幕这一步,没有配音、没有多工具矩阵、没有桌面端——如果你只在本地隐私环境里要个字幕,选它;要做完整成片,OpenCreator 覆盖面大得多。pyVideoTrans 这类单体翻译工具:轻、快、专一,但同样是只解决翻译一段,配音和平台化排版要自己接。两个方案的对比维度其实就一条:你要的是”一段字幕”还是”一条流水线”。
一句话收尾:OpenCreator 是那种”总装线”型工具,它不负责你的模型好不好,只负责把下载、转写、翻译、配音、排版这条最磨人的链子一次接完——顺手拉了下它今天的家底,14,179 个 star,11 月 3 日刚发的 v3.3.0,最近四周 146 次提交,改动节奏很快,装了就准备好跟着版本跑。我这边等额度到位装上桌面版,会把配音音色和竖屏排版这两块的实际成片效果单独补一篇。