
一套知识库,MIT 协议,Go 实现半夜找一份两年前的验收单
我平时写企业业务系统的代码,合同、订单这类模块做了好几年,最怕的不是写逻辑,是找文档。一个条款去年到底改没改过?验收单在谁手里?答案是开三个系统挨个搜:飞书里翻聊天记录,Confluence 里翻空间,共享盘里还有一堆没人命名的 PDF。有一次为了对一句话的出处,我翻到晚上十一点,最后在一位已经离职同事的个人空间里找到了。
同事也试过别的路子。拿 Dify 之类的工具搭过一个问答机器人,问答是有了,但知识沉不下来——答案说完就说完,库里到底有什么、这些文档之间是什么关系,没人知道。过俩月文档更新了一版,机器人还在拿旧内容答人,用的人就再也不打开了。
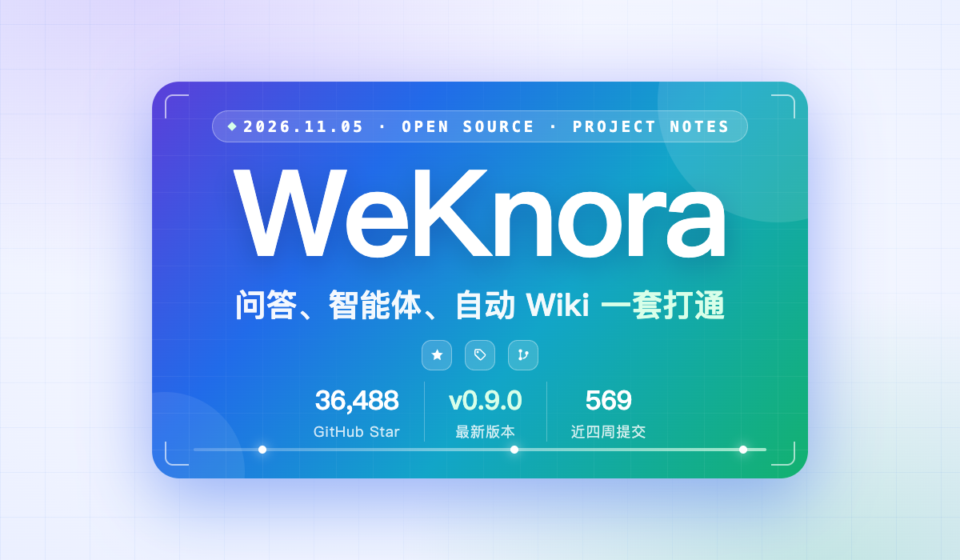
九月底刷 GitHub 的时候,我把腾讯微信团队开源的 WeKnora 认真看了一遍。这仓库 2025 年 7 月创建,一年多涨到三万六千多个 star,MIT 协议,Go 写的。它干的事一句话能说清:把散落的文档收进一个知识库,然后在这个库上同时跑三样东西——检索问答、会干活的智能体、自动生成的 Wiki。我当时没急着装,先把 README、安装文档和四百多个 open issue 翻了一遍,顺手把社区里几篇实测文章也读了。这篇就是把翻出来的账摊开讲讲。
一套知识库,三种吃法
先说问答这条主线。WeKnora 的检索是关键词加向量的混合检索,配 rerank 和父子分块,答案带引用,v0.8.3 之后还能从答案直接跳到引用段落在原始文档里的位置。这个细节我看重——企业里推一个问答工具,死活就在”敢不敢信”三个字上,答案后头没出处,工艺员看两眼就关了。
第二样是会干活的智能体。ReAct 那套多步推理,接 MCP 工具、联网搜索,技能从 ClawHub、Git 或 ZIP 包装进来,跑在 Docker、E2B 这类沙箱里,v0.9.0 又加了多智能体协作和定时自动化。跨会话记忆也有,用户的偏好和确认过的事实会留下来。
第三样是我最感兴趣的:Wiki。开启之后它从知识库文档里抽实体——人物、产品、概念——自动生成互链的 Wiki 页面,配知识图谱,页面能直接编辑,每次改动有版本 diff,可以回滚。有位博主实测喂了一百多篇公开专利,自动生成 18 条摘要、97 个实体、一张 500 节点的图谱。这就是我上面说的”知识沉下来”:文档不只是被查,是被整理成了能顺着读的东西。
外围的配套也齐:飞书 wiki、飞书云文档、Confluence、GitLab、Notion、语雀、钉钉文档、Seafile、RSS 这些数据源能自动同步;PDF、Word、Excel、XMind、图片等十几种格式能解析;问答可以接到企微、飞书、Slack、Telegram,还能通过内置的 MCP Server 把知识库发布给 Cursor、Claude 这类工具用。
有两块容易被当成附属品、但我认为对企业落地是硬需求的,单拎出来说。一是权限和审计:多空间 RBAC,四种角色,资源有归属,每个空间有审计日志,凭据用 AES-256-GCM 加密存储,还能接 OIDC 单点登录。知识库一旦放开给多个部门用,谁改了什么、谁问了什么,出事必须查得到,这不是锦上添花。二是可观测:智能体每一步的推理和工具调用、token 用量,都能接 Langfuse 追踪;文档解析有分阶段的时间线,卡在哪一目了然;还有任务队列面板,排队和失败的任务看得见。这两块很多同类开源项目要么没有、要么做得很糙,WeKnora 是当成正式功能做的。
哪些是真本事、哪些还在半路,我按证据说。问答检索这条链路是骨架,issue 区和第三方实测都验证它通,这是最稳的部分。Wiki 生成是亮点,实测反馈不错,但注意它烧 token——后面算账。智能体那套沙箱和本地浏览器,方向对但重:v0.8.2 的升级说明里官方自己标了一条 breaking,沙箱命令默认以 root 跑;要启用 Docker 沙箱得挂载 docker.sock,官方文档明说这”等同宿主机 root”。生产上我建议这部分先关着,问答和 Wiki 先跑起来。
什么都可换,代价写在账单上
WeKnora 的架构哲学是”全都可以换”:模型内置 29 家厂商(OpenAI、DeepSeek、Qwen、混元、Ollama 都在),向量库九种,从 pgvector 到 Milvus、Qdrant、Weaviate、Apache Doris,对象存储八种。好处很直白,不被任何一家锁死,客户指定什么就能接什么。
但每多一个可选组件,就多一份集成和排障的活。公众号上一篇真机实测的原话我记到现在:”可换意味着两件事:不会被单一供应商锁死,以及每多一个可选组件就多一份集成和排障的活。”我完全认同,而且想补一句:九种向量库里真正被大量验证过的就是默认的 ParadeDB(PostgreSQL 加 BM25 和向量扩展),你挑冷门那几个,等于帮官方做测试——open issue 里 Milvus 注册失败不重试(#5126)、Weaviate 拿 chunk ID 当对象 ID 互相覆盖(#5009)都是真实存在的。
部署面的重量也值得单说。Go 单体后端之外,文档解析是独立的 Python 服务 docreader,走 gRPC,里面塞了 LibreOffice、OpenJDK 17、Playwright。一位博主量过:docreader 单个镜像 5.69GB,五个容器合计约 10.7GB。为什么这么重?解析 Office、渲染 PDF 这摊事,Python 生态确实是最省力的路,官方也提供了进程内的 anydoc 解析引擎给轻量场景,但重解析这条链路的成本就是躲不掉。
升级这件事也有自己的脾气。官方文档反复提醒:只跑 docker compose up -d 会复用本地缓存的旧镜像,Web UI 显示的版本可能和你以为的对不上;升级前要把 .env 里的 WEKNORA_VERSION 改成目标版本再 pull。更狠的一条是数据库:Compose 默认的 ParadeDB 镜像跨版本升级不是换个镜像就完事,pg_search 扩展要单独处理,官方升级说明专门写了一节。把这些归拢成一句话:升级要进运维日程,不是顺手敲两条命令的事。
还有一笔更隐蔽的账:重建。全站讨论最多的 issue 是 #1679,77 条讨论,诉求就一句话——重建或重解析知识时,把 OCR、Embedding、Wiki 的缓存复用上,别全量重算。现在换一次 embedding 模型,所有文档重新解析、重新向量化,时间和 token 全部翻倍。掘金一位作者就撞上了:换模型之后向量维度不匹配,只能重建整个知识库。这个坑在有几万篇文档的库上会非常疼。
什么情况下这套设计不可接受?两种。一是你想把知识库能力嵌进自己的产品做二次开发——三百多个 API 端点、约一百五十个环境变量,加上一个不轻的部署面,定制成本不低,这种场景不如自己拿轻量组件拼。二是完全没人碰容器运维的团队,五容器加模型 key 这套账养不动。
装之前先看秤
硬件要求这次不用猜,官方文档写得明明白白:标准 Docker 部署建议 4 核 CPU、8GB 内存起步,docreader 含 LibreOffice 和 Playwright 比较吃内存;这个 8GB 不含 Ollama 模型权重的开销,启用 Milvus、Langfuse 这些可选组件还要再加。
实践反馈比官方数字更狠一点:CSDN 一位作者 8GB 的机器跑出了 OOMKilled,升到 16GB、限制同时向量化的文件数才稳住。所以我的两档建议是这样:
最低可用档:Lite 单二进制。SQLite(FTS5 全文检索加 sqlite-vec 向量检索)加内存队列,零外部依赖,不用 Docker,数据全在本地,默认只监听本机。配置也简单:发行包里把 .env.lite.example 复制成 .env.lite,填上密钥就能跑,程序自己会找这个文件。代价是解析引擎只有 Simple 档、没有多空间协作,另外官方的桌面应用还没正式发安装包,想用图形界面得自己从源码打包。个人试用、几十上百篇文档的量,这档够了。
建议档:4 核 16GB、磁盘 50GB 起(镜像约 10.7GB,再加 Postgres 数据卷和文件卷),模型走云 API 或内网 Ollama,检索用默认 ParadeDB 别折腾。
标准部署的步骤官方写得很短:
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env
docker compose pull
docker compose up -d
两个必须自己动的点:.env 里的 JWT_SECRET 和 SYSTEM_AES_KEY 默认留空,首次部署要生成(官方给了 openssl rand -hex 32 和 openssl rand -hex 16 的命令);尤其 SYSTEM_AES_KEY,升级时绝不能换,换了已加密的凭据就解不开了——官方用 warning 标了这条,别不当回事。
那五分钟流程,我对着文档走了一遍
先交代实话:我还没把标准版装进自己的机器。这几天手头有事,五容器一套不是我周末愿意随口试的东西,Lite 版倒是我打算最近真跑一次的。所以这一节的命令来自官方 CLI 手册,预期表现来自两篇第三方实测,出处都给全。
五个容器全部 healthy 之后(公众号那位作者从 clone 到全部就绪花了约 25 分钟,大头是拉镜像),官方 CLI 的最小闭环长这样:
weknora profile add prod --host http://localhost --use
weknora auth login
weknora kb list
weknora link --kb my-knowledge-base
weknora doc upload notes.md
weknora doc wait doc_abc
weknora search chunks "退货条款是哪一年改的"
weknora chat "总结这份验收单里我方义务"
doc wait 会阻塞等解析完成,退出码 0 是成功、1 是失败;search chunks 是检索调试命令,直接看命中了哪些分块,调参全靠它;chat 流式输出,答案带引用。整个 CLI 默认吐 JSON,--format text 才是人读格式——它是按”给程序和智能体调用”设计的,取向很明确。CLI 目前没有预编译产物,要用得装 Go 1.26 进 cli/ 目录自己 build,官方说预编译二进制和 Homebrew 配方计划随某个正式 tag 一起出,到现在还没兑现,这点先说在前面。
服务起没起好,探活一条命令就够:curl http://localhost:8080/health,返回 {"status":"ok"} 说明后端就绪。注意别打到 /api/v1/health,那个要登录态,没带凭据就是 401,很多人在这儿白折腾。
两个预期数字供参照:一,问答链路第三方验证是通的,建库、上传、引用问答全流程没断点;二,解析成本要留预算,夜雨聆风那位博主用 DeepSeek 的 API 解析一百篇专利,一上午花了 21 块钱。文档量大的时候,这笔钱和 #1679 那个重建重算是乘法关系。
别人踩过的坑,我按出处列
这部分全是我翻出来的,每条带出处,不是我编的:
- 镜像拉完起不来,报 “must be built from source”——手动
docker pull wechatopenai/weknora-app和wechatopenai/weknora-docreader两个镜像再up -d就过(微信公众号「3万星WeKnora实测」,真机 Linux 部署)。 - 登录只认邮箱,注册必须带 username,少一个字段报 1010 校验错(同上)。
- 探活路径别用错:
/api/v1/health要登录态,报 401 不是挂了,用根路径/health(同上)。 - 模型名必须一字不差:本地 Ollama 写
qwen2.5而实际注册的是qwen2.5:7b,服务端静默返回空结果,排查了很久(CSDN 部署实战文)。接任何模型服务,先在模型服务自己的接口上把名字验一遍。 - 复杂版面的 PDF 会丢结构,表格乱掉,先转 Markdown 再传(掘金部署实录)。
- 回答有内容没引用,多半是检索阈值过高或 top-k 太小,调参能救(同上)。
- 换 embedding 模型要重建知识库,向量维度不匹配,索引全废(掘金)。embedding 模型定了就别动。
- 还没修的:invite_only 模式下受邀者卡在登录页(#2985);xlsx 大文件解析超时(#5110);自托管 Langfuse 看不到 token 用量(#5078)。需求侧,MySQL 作为底层数据库(#1418,44 条讨论)、问答点赞点踩(#1248,51 条)都还在排队。
总结一下这批坑的分布:镜像、登录、探活这类是首次部署的一次性摩擦,照着清单过就行;模型名、embedding 维度、解析质量这三个是长期成本,上线前把规范定死能省很多后患。
我的判断
值不值得上手?值得,但要挑对形态和场景。
它的主场很清楚:文档散在飞书、Confluence 这些系统里,数据不能出内网,团队用企微或飞书,希望问答之外知识还能沉淀成 Wiki 和图谱。这几条全中的话,WeKnora 是目前开源里完成度最高的选择之一,腾讯自家企微和微信对话开放平台的接入通道是现成的,如果你的场景本来就在微信生态里,这一项能省不少对接活。
不适合的也直说:个人只有几十篇笔记,Lite 之前的方案都不用看;想把它当组件嵌进自己产品深度二开的,Go 单体加三百多个端点,改起来不轻;没有运维余量、也不想付模型 API 费的,这套东西养不动。还有一个前提别忘:它自带登录,但官方文档明说生产环境别直接暴露公网,知识库泄了比没有知识库严重得多,放内网、配防火墙这条要照做。
替代方案点名两个。RAGFlow,解析能力更深,DeepDoc 对复杂表格和版面的处理更强,适合把解析质量放第一位、有专人伺候容器的团队,代价是整个平台更重、更专业向。Dify,编排和应用搭建是主业,知识库只是其中一环,浅但轻,适合问答只是诸多功能之一的场景。选型维度一句话:重解析选 RAGFlow,重编排选 Dify,重”沉淀”——问答之外还要长出 Wiki 和知识图谱的——选 WeKnora。
最后说句实在的,WeKnora 是我最近翻过的开源知识平台里,少数把”问答之后呢”想清楚了的一个——大多数工具到引用问答就停了,它接着把知识整理成能读、能改、能回滚的 Wiki,这一步是真有价值的。顺手查了下,现在是 36,488 个 star,v0.9.0 是 10 月 29 日发的,最近四周 569 次提交,节奏很稳。一句话:想试的人从 Lite 单二进制开始,十分钟见分晓;要上生产的,先把 16GB 内存、模型预算和 #1679 那笔重建账想清楚再动手。总而言之,工具是好工具,养不养得起,取决于你们团队有没有那个人。