
朋友的痛点,正好撞在枪口上
先交代背景:我手头只有一台 M 系的 Mac,没有 N 卡,所以这次没装、没跑,走的是把文档和 issue 翻烂的路线。上一个项目 distributed-llama 我还能在 Mac 上编译跑通,这个项目直接把我劝退在硬件门槛前——它要 CUDA,没得商量。但这个项目我盯了一个多月,值得写。
为什么盯上它。我上次折腾 FunASR 的时候就有个强烈的感受:语音识别装完还要自己糊一层服务,跟后面接的生图工具链完全两套逻辑,配置文件互不相认。我一个做电商系统的朋友情况更糟:商品主图批量生成挂了一个 diffusion 推理脚本,客服语音合成养着另一个 TTS 服务,最近又要上短视频配音,三个模型三套部署脚本,改一个参数要登三台机器。他跟我抱怨的原话是”我就想调个并发数,为什么要看三份文档”。
这就是多模态模型推理的现状:模型百花齐放,serving 一地散装。文本大模型有 vLLM、SGLang 这种成熟调度器,批量、缓存、并发全都安排好了;而 TTS、文生图、视频生成这些模型,大多是模型作者自己写的推理脚本,demo 很丝滑,真要对外服务就得自己补调度、补缓存、补并发——补完还得分别做监控、扩缩容和故障恢复,运维负担是三倍而不是三遍。vLLM-Omni 干的就是这件事——把 vLLM 那套服务化能力搬到全模态模型上。它是 vLLM 官方社区 2025 年 11 月发布的亲儿子项目,不是外面谁蹭着 vLLM 名头做的皮包框架。
把调度器接给扩散模型,这事它是真做了
按能力分组说,也说说我自己的判断,哪几个是真能用,哪几个还嫩。
第一块,统一的服务入口。 一条命令把模型拉起来,OpenAI 兼容的 API 直接对外:
vllm serve Tongyi-MAI/Z-Image-Turbo --omni --port 8091
注意那个 --omni,这是 vLLM-Omni 的分诊开关——vLLM 拥有命令行入口,见到这个旗子才把请求转交给 Omni 运行时。对外接口跟 OpenAI 的 images API 长一个样,客户端代码几乎不用改。这是我认为最实在的一块:把”模型推理脚本”变成”服务”,调度、批量、并发由框架接管。
第二块,离线批量推理。 十行 Python:
from vllm_omni.entrypoints.omni import Omni

if __name__ == "__main__":
    omni = Omni(model="Tongyi-MAI/Z-Image-Turbo")
    prompt = "a cup of coffee on the table"
    outputs = omni.generate(prompt)
    images = outputs[0].images
    images[0].save("coffee.png")
传一个 prompt 列表进去,扩散流水线会把在途的独立请求自动凑批,调度器和 runner 帮你排队。
第三块,模型覆盖面。 官方支持列表里,全模态模型有 Qwen3-Omni、MiniCPM-o 4.5;TTS 有 Qwen3-TTS、CosyVoice3;扩散类有 Qwen-Image 2.1、Wan2.2、LTX-2.5;甚至机器人策略模型 π0.5、GR00T-N1.7 也在列。覆盖广是真广,但成熟度不均匀:TTS 和文生图有官方 recipe、有 Docker 镜像、有第三方部署实录,是真能用的;世界模型和机器人策略还在铺路阶段;diffusion 调度器目前只支持单请求,吞吐型场景吃亏——这条是 hysenlabs 那篇长文里的说法,我按 issue 区的动态交叉看了一下,方向一致,但具体数字我没条件复核。
第四块,实时全双工。 0.30.0 引入了 session-aware 的全双工 serving,音频流进、音频流出,服务端还带 VAD 做轮流对话,0.32.0 又把服务端 VAD 扩展到基于轮次的 realtime 请求。做语音助手这类交互场景,这个能力是刚需,而目前把它做进 serving 框架的开源项目屈指可数。
第五块,部署配套。 官方维护了一个专门的 recipe 站点,按模型逐个给部署参数——Qwen3-Omni、MiniCPM-o 4.5、MiniMax H3、LingBot World 这些都有独立页面,标清楚推荐的卡数、并行策略和采样参数。Docker 镜像除了版本号标签,还有 nightly 滚动版和按 commit 钉死的 nightly-
第五块的背面是成熟度问题。 我的判断是:TTS 和文生图这两块是真能用——有 recipe、有镜像、有第三方完整部署实录;视频生成和世界模型还处在”跑通 demo”的档位;机器人策略模型最嫩,基本是占位姿态。diffusion 调度器目前只支持单请求,吞吐型场景吃亏——这条是 hysenlabs 那篇长文里的说法,我按 issue 区的动态交叉看了一下,方向一致,但具体数字我没条件复核。全双工那条线看架构是认真的,但迭代太快,我后面会讲它带来的代价。
跟 vLLM 锁死版本,是设计也是枷锁
它的架构选择我怎么看。核心是 stage 流水线:把一个全模态请求拆成多个阶段,自回归部分复用 vLLM 的 KV cache 管理,扩散部分走 DiT 运行时,阶段之间用 OmniConnector 做数据传递,各阶段可以分配到不同的卡上,流水线重叠执行。
这个设计聪明在”借力”:文本部分不用重写,vLLM 十万级用户验证过的调度器直接用;聪明在”拆”:理解模型和生成模型显存画像完全不同,拆开按需分配,比塞在一个进程里灵活得多。0.28.0 又把 AR 和 DiT 两条线统一进了同一套 paged KV cache 运行时——扩散模型的中间状态也按页管理,显存碎片的老大难问题从框架层面收口。0.30.0 更进一步,跨阶段的 KV 和多模态数据传输接上了 Mooncake 和 NIXL 连接器,识别完的语言状态可以直接交给生成侧接着算,不用重新编码。
代价也很清楚,我挑三个最硬的说。
第一,版本跟 vLLM 锁死。 官方文档白纸黑字:vLLM 和 vLLM-Omni 的 major.minor 版本必须一致,不然 import 就报警告,行为可能不对。想升 vLLM 主线,Omni 会被一起拖动。我翻了它的 release 记录,从 2025 年 12 月第一个版本到现在发了 33 个,几乎每个偶数位 vLLM 版本都跟一发——节奏快是好事,但也意味着你的运维节奏被绑上了它的发版车。
第二,Alpha 身份是官方自己标的。 我特意去仓库翻了 pyproject.toml,classifier 里明晃晃写着 Development Status :: 3 - Alpha。stage 级的接口在 minor 版本之间会变,长生命周期的集成要么钉死版本不升级,要么做好每次升级改代码的准备。
第三,跨阶段传输还在还债。 hysenlabs 那篇提到跨阶段数据目前经 CPU 中转(D2H2D),直连在路线图上;编排器毫秒级轮询在高并发下可能成单点。这类架构细节我没条件实测,标注为第三方说法,但跟 issue 区对性能优化的几条 RFC(比如 #7382 kernel 复用、#8586 Qwen-Image 内存优化)的抱怨方向能对上。
什么情况下这个代价不可接受?一句话:对 API 稳定性有硬要求、又不肯钉版本的,现在别上。反过来,如果你的服务本来就是短平快、能接受跟着发版节奏走,Alpha 标签没那么可怕。
装它之前,先把 Linux 和 CUDA 13 这两关过掉
官方给的条件很明确:Linux,Python 3.12,NVIDIA 卡算力 7.0 以上——等等,我核对了三遍文档,GPU 页写的是 compute capability 7.5 或更高(T4、RTX 20 系、A100、L4、H100 都行),不支持 Windows。稳定版 wheel 是 0.32.0,两条命令:
uv pip install vllm==0.32.0 --torch-backend=cu130
uv pip install vllm-omni==0.32.0
要跑 Gradio demo 就再加一行 uv pip install 'vllm-omni[demo]==0.32.0'。想追最新主线就得源码装,而源码装有个挺离谱的前置:0.33 这条线要用一个临时构建的 Gradio backport 轮子(为了满足 vLLM 对 Pillow 13 的依赖要求),先跑 python tools/build_gradio_pillow13.py 造轮子再一起装。光看这串说明我就头皮发麻,能上 Docker 就别源码折腾。
Docker 是我最推荐的路子,官方镜像 amd64 和 arm64 都有:
docker run --runtime nvidia --gpus 2 \
    -v ~/.cache/huggingface:/root/.cache/huggingface \
    --env "HF_TOKEN=$HF_TOKEN" \
    -p 8091:8091 \
    --ipc=host \
    vllm/vllm-omni:v0.32.0 \
    vllm serve Qwen/Qwen3-Omni-30B-A3B-Instruct --omni --port 8091
除了 NVIDIA,它还认 AMD ROCm(验证到 gfx942)、Intel Arc B 系、摩尔线程 MUSA(验证到 S5000)、昇腾 NPU——国产卡适配比大多数同类项目积极,这一点值得单独夸一句。
硬件门槛官方没给整机内存表,这点我直说。官方只标了 GPU 算力下限和系统要求,显存和内存给不了两档精确数字,下面是我按官方 Docker 示例、模型体量和第三方部署文推的,不是官方口径:
- 最低可用:单卡 24GB(RTX 4090 级别),跑 TTS 小模型或文生图。参考系:一份 Qwen3-TTS 的第三方接入文档写明 0.6B 模型约 3-4GB 显存、1.7B 约 6-8GB——这组数字是官方 backend 的口径,Omni 路径只会多不会少。系统盘留 150GB 以上,模型权重、依赖和缓存都吃盘。
- 建议配置:双卡 24GB 起步(官方 Docker 示例就是
--gpus 2跑 Qwen3-Omni-30B-A3B-Instruct),CUDA 13 兼容的驱动,内存 64GB 往上,别让 host 内存成为跨阶段传输的瓶颈。
照官方 Quickstart 过一遍:代码十行,坑在版本号
我的环境跑不了,所以这节是照着官方 Quickstart 逐条核对的流程,不是实测,预期输出也是文档原样。但这套流程简单到没有智力门槛,值得原样收走。
离线路径上面给过了。在线服务路径,起服务后一个 curl 出图:
curl -s http://localhost:8091/v1/images/generations \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "a cup of coffee on the table",
    "size": "1024x1024",
    "response_format": "b64_json",
    "seed": 42
  }' | jq -r '.data[0].b64_json' | base64 -d > coffee.png
文档里给的关键提醒有两个:一是 vLLM 和 vLLM-Omni 版本必须同 major.minor,错位会警告;二是如果 vllm 命令不认 --omni,先确认当前环境里两个包都装齐且版本对齐——CLI 入口在 vLLM 手里,Omni 只是接活的一方。另外提醒一句,扩散请求每个 prompt 是独立逻辑请求,想控制批大小和步数的细节要去文档的 Diffusion Execution Modes 一章翻,quickstart 里没有展开。
我的建议是把第一轮目标定成”跑通入口”而不是”出第一张图”:环境装好、--omni 行为确认、collect-env 输出跟机器对得上,然后只挑一个模型一个任务打。这是那位把整个安装链路实测了一遍的 CSDN 作者的结论,我完全同意——照着旧 issue 和旧博客抄命令,比下模型本身更容易浪费半天。
多卡花屏、并发复读、冷启动一百秒,都是真事
issue 我翻了几轮,这个仓库累计 2,894 条 issue(含已关闭),高频高评论的大多是 RFC 路线讨论,真正使用层面的坑要从 bug 区捞。挑几条硬的:
- 多卡出图花屏。 #8135 报告 Qwen-Image 2.1 在 TP=2 下输出密密麻麻的色斑噪点,单卡干净;更狠的是同一张卡上 SGLang TP=2 也复现同样的花屏,说明问题可能在模型或跨卡通信链路,不只是某一家框架的锅。同类还有 #9590,0.32.0 官方镜像启动和生图时一堆警告,出图扭曲。结论:上多卡前先用单卡验一遍出图质量。
- 并发下 TTS 数字复读。 #9522,VoxCPM2 在并发批量解码时,句首句尾的数字偶尔重复。TTS 高并发场景上线前值得专门压一轮数字类文本。
- CLI 参数不校验。 #5728,
--stage-overrides传进无效的配置项不会报错拒绝,而是静默吞掉——你以为调了参数,实际没生效。这种”安静的忽略”比崩溃难查多了,调优时建议每改一个参数都做一次前后对比。 - 版本错位导致架构不识别。 普通方式起一个 omni 模型会报”不支持的模型架构”,根因是忘了
--omni或版本没对齐——那位 CSDN 实战作者把这条排进高频报错表的第一行。 - 容器 OOM。 同一篇实战文给出 Docker 运行直接崩的解法:共享内存不足,加
--ipc=host --shm-size=8g。官方示例里那行--ipc=host不是装饰。 - 冷启动慢。 hysenlabs 那篇(第三方转述,未复核)说 TTS 冷启动约 100 秒,官方 backend 约 11 秒,容器自动扩缩容场景吃亏,解法是预热
TTS_WARMUP_ON_START=true。同一篇还说别在 Omni 上开 Flash Attention 2,实测反而退化 8%,vLLM 自家的注意力优化跟 FA2 冲突。
公开讨论里中文社区的实战文不少(知乎、CSDN、GitCode 都有),Reddit r/StableDiffusion 上有 Cosmos3 部署实测和 Qwen3-TTS 并发测试的帖子,HN 上讨论不算热。还有一个观察:这个仓库的 issue 区里 RFC 和 bug 混在一起,好几条高评论的”issue”实际是官方路线图征集,社区话语权集中在核心团队手里——参与讨论前先看清议题性质,别把 roadmap 当 bug 报。整体印象:吵得最凶的不是”能不能用”,而是”该不该这么早 Alpha”。
我的判断:别拿它当第一个推理框架,但值得排进观察名单
值不值得上手?我的答案分人,而且分得很清楚。
已经在跑 vLLM、要给产品加 TTS、生图或视频生成能力的团队,这是目前最顺的路——模型覆盖、OpenAI 兼容接口、国产卡适配三样加起来,竞品没有一个凑得这么齐。想研究统一 serving 抽象的工程师,它的 stage 流水线和 OmniConnector 也值得读源码。反过来说,纯文本场景直接用 vLLM 主线,别多此一举;只想在单机上快速跑个模型看看的新手,这项目的信息密度会把人淹没。
替代方案点名两个。SGLang 是同赛道最接近的对手,多模态和扩散 serving 也在快速跟进,上面那条花屏 issue 里两家同病相怜,对比维度看模型覆盖(Omni 明显更广)和社区规模(SGLang 历史包袱少但生态也小)。ComfyUI 是单机生图的另一极——工作流可视化、节点生态丰富,但它压根不做服务化调度,对外提供并发服务还是要自己套壳。要”服务”选 vLLM-Omni 或 SGLang,要”玩”选 ComfyUI,两条路线的边界其实相当清楚。
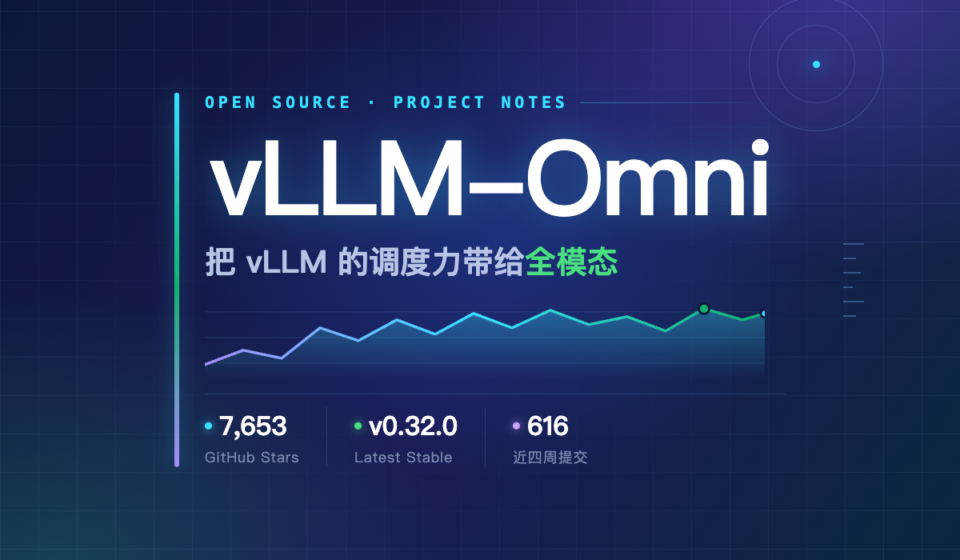
总而言之,这是我这个月看过迭代最快、野心最大的推理项目:13 个月,33 个 release,官方技术报告都发了两篇。顺手拉了下,现在是 7,653 个 star,最近四周 616 次提交,仓库今天凌晨还在动。最后说句实在的,全模态模型迟早要走文本模型走过的路——从研究脚本进化到真正的服务化调度,而站在那个路口的第一梯队里,这个项目已经站住了。我等它哪天把 Alpha 标签摘了,就真的把朋友的电商系统搬上去试。