
我为什么盯上它
先交代一个我自己疼过的场景。
我手上有一台小服务器,上面跑着七八个 crontab 条目:数据库备份、日志切割、证书续期检查、一个每天拉对账文件的脚本。它们单独看都没问题,写的时候也都是「一条命令,五分钟搞定」。
后来出了一次事:备份脚本连着三个晚上静默失败,原因是磁盘满了,脚本没有做任何失败通知。第四天我要恢复一个误删的表,打开备份目录才发现最近一份完好的备份是三天前的。那天的感受我到现在还记得——不是紧张,是一种「我居然一直这么裸奔」的后怕。
我想加的东西其实很朴素:失败了我得知道;A 完成了才能跑 B;每一步的日志别让我 ssh 上去翻;偶尔脚本要人工确认一下再往下走。
然后我去看了主流方案,然后我就怂了。Airflow 要一个 metadata 数据库、一个调度进程、一组 worker、一套 Python 环境,我那七八个脚本得重写成 @dag/@task 的框架代码。Temporal 更狠,业务逻辑直接进它的 SDK。为一个备份脚本上个平台,我觉得我是在给自己造第二个工作。
所以我一直在找一个中间态:能接住我现有的脚本,不逼我重写,还能把依赖、重试、日志、历史这几件事补齐。Dagu 的定位正好打在这个点上——它的 README 原话是「for teams whose main work is not orchestration」,编排不是你的主业。一个 Go 写的单二进制,内置 Web UI,不依赖外部数据库和消息队列,脚本还是你的脚本,编排关系写在旁边的 YAML 里。
这次我没像往常那样直接在本机装一个跑起来——最近手上的机器腾不出干净环境,而它官方挂着一个开着完整 Web UI 的在线 demo(账号密码都是 demouser),docs 站把每条命令的行为都写清了。所以这篇的写法换了个路数:我把官方文档、九百多个已关闭 issue、还有几篇第三方实测从头到尾翻了一遍,能确认的和不能确认的,我都分开说。
一个二进制到底管了哪些事
Dagu 的能力清单很长,我按「真的能用」和「看着热闹」两档拆。
第一档:把散装脚本变成有依赖图的作业。 这是它的基本盘,也是我这次盯上它的原因。一份 YAML 描述步骤和依赖:
# backup.yaml
schedule: "0 2 * * *"
steps:
  - name: dump-db
    command: bash /opt/scripts/dump.sh
  - name: upload
    command: rclone copy /backup remote:backup
    depends:
      - dump-db
    retry:
      limit: 3
      interval: 5m
  - name: notify
    command: curl -s https://hook.example.com/ok
    depends:
      - upload
调度用标准 cron 语法,支持时区、重叠策略(上一次还没跑完怎么办)、catch-up 窗口(错过的时间点要不要补跑)。这三样恰恰是 crontab 裸奔时最疼的地方。官方文档的 Quickstart 给的验证路径是 dagu validate 校验语法、dagu dry 干跑、dagu start 实跑,dagu start-all 一条命令把 Web 服务、调度器、执行器全拉起来,默认端口 8080。这套流程在文档和多篇第三方文章里的描述是一致的,命令行为可信。
第二档:执行器比我想的宽。 除了 shell,它内置了 Docker 容器、Kubernetes Job、SSH 远程执行、SFTP、HTTP 请求,还有 Postgres / SQLite / ClickHouse / Redis 的查询步骤,S3 的上传下载。这意味着「本地生成文件 → SSH 到远端执行部署 → 回调 HTTP 通知」这种跨环境链条,可以写在同一份 YAML 里。对运维型工作流,这个覆盖面够用了。
第三档:人工环节和状态管理。 human task 能让流程暂停等人确认或输入,确认结果还能传给下游步骤。发布、数据修复这类要先看一眼再放行的操作,不用再把审批塞进聊天记录里。另有跨运行持久的 state.* 步骤和 artifact 机制。
第四档:新的、得存疑的。 v2.24.0 的更新日志里有几条值得注意:chat.completion 直接跑大模型对话步骤;harness.run 把 Claude Code、Codex、Gemini CLI 这类编码助手 CLI 当成一个步骤编排;browser.run / computer.run 用自然语言驱动浏览器和桌面操作;还有内置的 MCP 服务端,接上客户端后可以查工作流、改定义、控运行。方向很有想象力,但好几篇第三方文章都指出这些标记为 new 的功能接口还在变——unsubbed 的评价是「expect rough edges and evolving APIs」。我自己的态度是:编排我那几个脚本的部分我信,这批新东西先观望。
顺带一提它社区版的开源协议是 GPL-3.0。自用、公司内部跑都没问题;但如果哪天你要把改过的版本打包进自己的产品分发,就得开源你的修改。SSO、RBAC、审计日志这些企业治理能力不在社区版里,官方的付费自托管许可从每月 50 美元起。
文件当数据库,这笔账怎么算
这是 Dagu 全部取舍的核心,值得单独说。
传统编排器的架构是 Web 服务 + 调度器 + worker + PostgreSQL + 消息队列,五个起步的进程,换来的是事务性的状态存储:任务跑到哪一步、失败了没,落库,机器崩了也能恢复。Dagu 把这些全砍了,状态、历史、日志全部落本地文件,整个引擎一个进程。
好处是实打实的:没有数据库要备份调优,没有消息队列要监控,升级就是换个二进制文件。官方的说法是一台机器一天能跑数千次工作流,实际容量取决于 CPU、内存、磁盘和工作流形态。
代价同样实打实,而且我要把它说重一点:文件存储的一致性和灾备保证,天然弱于数据库。hysenlabs 的长文把这一条列为它最大的短板——README 没有讨论机器在运行中途崩溃、或者两个 worker 同时写同一组文件时会发生什么。仓库里长期挂着 issue #539「About database supported」,讨论的正是这个架构疑虑。官方其实对此是诚实的,文档里 Kubernetes 部署要求 ReadWriteMany 存储类,这个细节已经暗示了多节点共享文件状态需要专门的存储设计。
还有一层代价在表达力上。YAML 是静态的:CloudRaft 那篇 Airflow 对比文列得很清楚——YAML 里不能内联 Python,步骤之间没有 XCom 那种内存级传值,DAG 结构不能在运行时动态生成。想要动态 fan-out,得在命令层自己想办法;想要 sensor 等文件就绪,用 precondition 加重试模拟。这些都能绕,但「能绕」和「原生支持」是两回事。
所以我的判断是:这套设计换来的轻,适合「任务失败可以重跑、数据丢了可以重来」的场景——备份、报表、部署、媒体转码。如果你的场景是金融对账这种「一次执行必须恰好发生一次、历史记录绝不能丢」的活,文件态存储的保证级别不够,这个代价在那种场景下不可接受,别硬上。
装起来不难,门槛我帮你对过了
安装路径官方给了五种:一键脚本、Homebrew、npm、Docker、Helm。以我的机器(macOS)为例:
brew install dagu
# 或者一键脚本
curl -fsSL https://raw.githubusercontent.com/dagucloud/dagu/main/scripts/installer.sh | bash
配置和 DAG 默认在 ~/.config/dagu/,日志和运行状态在 ~/.local/share/dagu/。有个小细节:首次对空目录启动会自动生成五个示例工作流,不想要就设 DAGU_SKIP_EXAMPLES=true。
硬件门槛这次要如实交代:官方没有给出整机最低配置表。README 只有两句定性描述——「runs on limited H/W resources」(能跑在资源有限的硬件上)和吞吐取决于 CPU、内存、磁盘。我能找到的定量数据有两个来源:一是 issue #546 里的用户实测,单实例挂三个每几分钟一跑的 cron 作业,内存从 15MB 涨到九天后的 92MB,更早版本长 uptime 时曾超过 300MB——这条我放在下一节细说,但它至少说明引擎本体的内存占用是个位数到百位数 MB 量级;二是 mrkeyoor 的实测,在 3 核 8GB 的 Debian 容器里从源码构建成功(1066 个依赖包、370 秒编译完成)。注意后者是构建环境的配置,不是运行门槛。
所以两档配置我只能按这些旁证估,都不是官方数字:
- 最低可用:1 核 CPU、512MB 内存、几 GB 磁盘——跑十来个低频作业的机器,这个量级大概率够,历史上也有人在树莓派级别硬件上跑它的记录;
- 建议配置:2 核、2GB 内存,磁盘留给日志和运行历史(这玩意儿按次累积,别忘了做清理策略),多 worker 部署再加 ReadWriteMany 存储。
官方没写的东西我就不明说了,上面两档请当成「issue 和第三方实测反推的经验值」。
不装机也能过一遍:官方在线 demo 路线
这次我没本机安装,但我把官方那条「零安装验证」的路完整走了一遍,强烈建议你也这么开始:浏览器打开 https://dagu-demo-f5e33d0e.dagu.sh,账号密码都是 demouser,进去就是一个挂着真实数据的 Web UI——Cockpit 页面把排队、运行中、成功、失败的运行摆在一起,每个运行点进去能看到依赖图的逐步状态和每步的日志,Wiki 页面还能给工作流配文档。
看完 UI,把文档 Quickstart 里的命令序列过一遍(以下是官方文档给出的行为,我没有本机复跑,特此说明):
dagu validate backup.yaml   # 语法校验
dagu dry backup.yaml        # 干跑,不实际执行
dagu start backup.yaml      # 实跑一次
dagu start-all --dags .     # 起服务+调度器,当前目录作为 DAG 目录
预期结果:validate 对语法错误给出定位;dry 输出每个步骤将执行的命令和依赖解析结果;start 跑完后在历史里留下一次带逐步日志的运行记录;start-all 后访问 8080 端口就是和在线 demo 同款的界面。
另一条省事路线是 Docker 一行起服务,状态挂载到宿主机目录——注意官方特别提醒:这条命令默认不会把宿主机 Docker daemon 暴露给容器内的工作流,你的工作流如果要用 container: 步骤,需要按文档单独配容器执行环境;挂 socket 就等于把宿主机控制权交给工作流,这个警告写得很实在。
坑我都替你翻过了
这部分的每一条都有出处。
内存增长曾是它的老毛病。 issue #546「memory leak – high memory usage」累计 68 条评论,是这个仓库讨论最多的 issue:用户反映单实例跑九天,内存从 15MB 涨到 92MB,更早的时候长 uptime 曾超过 300MB。这个 issue 已于 2026 年 6 月关闭,但从评论时间线看是长周期拉锯。教训很简单:上生产前先做长周期观察,别拿跑一小时的体验外推到跑一个月。
文件态存储的灾备没人替你做。 除了前面说的 #539,开源社区的新鲜 bug 也能佐证状态管理的复杂度:#3379「Queued DAG definition cannot be built」10 月 29 日刚修复;#3413 浏览器步骤在同一个进程里上一步的登录态到下一步丢失,也是 10 月 29 日修复;#3375 是 Workers 标签显示不全。三天内连发 v2.22.3、v2.22.4、v2.24.0 三个版本,迭代快是好事,但也意味着升级前得读 changelog——文件格式类的状态存储没有数据库那种跨版本兼容承诺,备份 ~/.local/share/dagu/ 要成为习惯。
第三方验证没有全绿。 mrkeyoor 用干净容器从源码构建,依赖安装 116 秒、编译 370 秒都成功,但自带测试套件在 900 秒上限内只跑了 36/38 通过、2 个失败——它自己也承认看不到失败原因,不敢下结论,但「源码级验证比单二进制的宣传更重」这个观察我认同。
表达力的墙在复杂逻辑处出现。 CloudRaft 和 markaicode 的对比文都点名:没有动态任务映射、没有运行时生成 DAG、集成生态远小于 Airflow 的 provider 体系。opensourcedrop 的说法最直白:「YAML workflows get unwieldy fast」——简单的管道很好读,复杂分支逻辑会开始跟你较劲。
治理功能是付费墙后面的。 社区版只有 2 个自动化 API key,没有用户管理、SSO、RBAC、审计日志。两个人以内的小团队无感,超过十个人共用一套系统时你会发现大家共用账号——这时候要么上 50 美元一个月的 Team 档,要么换别家。
我的判断
值得上手,但只对特定的人。
如果你跟我一样,手上有十来个散装脚本和 cron 条目,它们的失败曾经咬过你,而你又养不起一个平台团队——Dagu 是我目前看到的迁移成本最低的答案:脚本一行不改,删掉 YAML 它照旧能跑,加上 YAML 就有了依赖图、重试、日志、历史和界面。内网、边缘、离线环境这种「装不了数据库」的地方,它是为数不多认真优化过的选项。
不适合的也直说:如果你的工作流复杂到需要动态生成任务、Python 函数级传值、或者几百个互相依赖的 DAG 跨团队共享,直接上 Airflow——它的 provider 生态和成熟调度换来的重,在那个规模是值钱的。如果你要的是「业务逻辑必须经受崩溃、跨天运行、恰好一次语义」,那是 Temporal 的地盘,Dagu 的文件态存储不提供这种保证。还有一个我犹豫很久要不要提的对照:Windmill。它和 Dagu 哲学相近(脚本优先、自托管),MIT 协议比 GPL-3.0 干净,UI 更完整、工作流定义的类型化更强——如果你对 GPL 和付费墙敏感,值得把它放进候选再比一轮,对比维度就看三条:协议、状态存储保证、治理功能的付费边界。
一句话总结我的判断标准:Dagu 解决的是「编排不是主业」的团队问题,一旦编排本身成了你的主业,它就到站了,你该下车了。
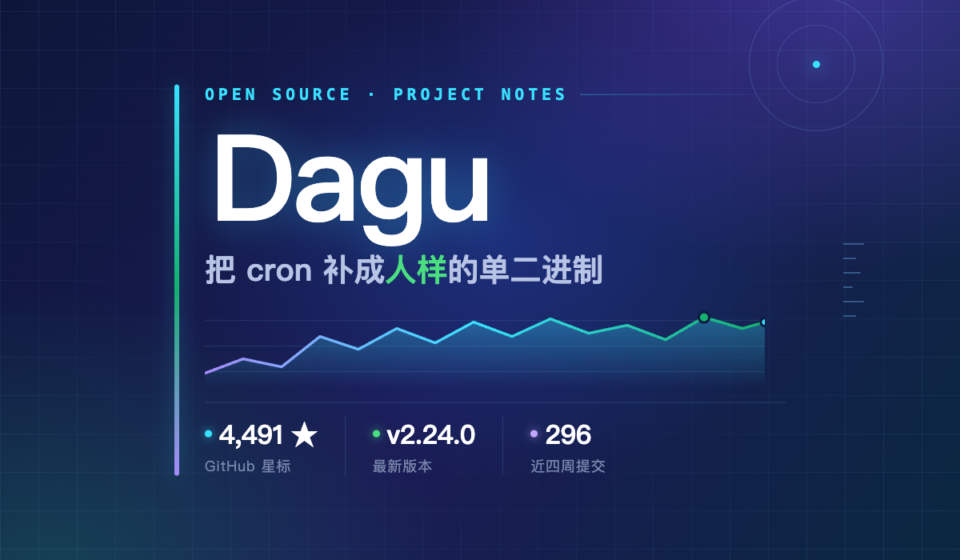
总而言之,这是个定位极其清醒的项目。顺手拉了下实时数据:现在是 4,491 个 star,最新版本 v2.24.0 三天前刚发,最近四周将近 300 次提交,issue 区开着一百多个、关了九百多个,活跃度没得挑。最后说句实在的,这类工具我建议的试用方式永远是同一个:挑一个挂了也不心疼的作业迁过去跑两周,看看凌晨三点失败的那次,你第二天早上是”碰巧发现”还是”收到通知”——答案会替你做完决定。