
我为什么盯上它
去年帮朋友公司调一个售后问答机器人,折腾了快一个月,最后卡在一个很尴尬的地方:客户问「这批轴承的游隙能调到 C3 组吗」,机器人答得像教科书,偏偏答不到点子上。行话全在 prompt 里塞着,一塞就是三千多 token,贵不说,模型还是抓不住重点。换 RAG 也试了,检索回来的段落南辕北辙,模型拿着错误的上下文一本正经地胡说。
那时候我们坐下来算了一笔账:术语就那么多,问答对攒了几百条,为什么不直接把这点东西训进模型里?念头有了,然后我打开了 transformers 的 Trainer——数据处理要自己写 collator,对话模板要自己对齐,显存不够要自己研究 gradient checkpointing 和 ZeRO 的组合,断点续训要自己管。我承认这些我都会写,但每换一个基座模型就得重对一遍模板,这种体力活干到第三天我就开始怀疑人生。
后来一个在魔搭社区混的朋友跟我说:你这些活,ms-swift 一条命令就包了。我当时是不信的,「一条命令微调」这种话我听过太多次,多半是 demo 能跑、生产拉胯。但这次我把它的文档和 issue 区翻了一遍,越翻越觉得这个项目被严重低估了——star 才一万五出头,跟它的实际完成度完全不匹配。
能干的事比 README 上看着多,但分真活和摆设
ms-swift 是 ModelScope 官方出的训练框架,名字展开是 Scalable lightWeight Infrastructure for Fine-Tuning。它覆盖的东西可以分五拨看。
第一拨:全链路命令行。 swift sft 训练、swift infer 推理、swift export 合并导出、swift deploy 起服务、swift eval 跑基准,一条命令对应一个环节,模型 ID 直接填魔搭或 HuggingFace 的仓库路径,权重自动下载。官方宣称支持 600+ 文本模型和 400+ 多模态模型,内置 150+ 数据集。我特意去翻了它的提交记录:10 月 29 日还在给 NVIDIA 新出的转写模型做 Day-0 支持,跟进速度是真快,不是 README 里的死数字。
第二拨:轻量训练方法。 LoRA、QLoRA、DoRA、LoRA+、LongLoRA、LISA 这些基本盘都齐,还能直接在 BNB、AWQ、GPTQ 量化过的模型上做训练。README 里有个数字我专门核了出处:7B 模型用量化训练只要 9GB 显存,这个写在官方特性列表里,不是我转述的二手传闻。
第三拨:大规模训练。 Megatron 后端的 TP/PP/EP 并行,DeepSpeed ZeRO2/ZeRO3,还有一整套 GRPO 家族的强化学习算法——DAPO、GSPO、CISPO、CHORD、RLOO、Reinforce++,rollout 阶段可以挂 vLLM 提速。这一拨看着唬人,但说实话,Megatron 那套对没有几十张卡的人就是摆设,GRPO 单卡跑个小模型玩玩可以,认真做 RL 那是另一个赛道的事。
第四拨:数据与导出。 这块是容易被略过、但真用起来最省心的部分。自定义数据集只要整理成标准的 messages 格式存成 jsonl,本地路径和魔搭的仓库 ID 可以混着传给 --dataset,#500 这种后缀直接控制采样条数,写小样验证脚本的时候特别顺手。训完的导出侧也齐:GPTQ、AWQ、BNB、FP8 四种量化导出,导出的模型直接接 vLLM、SGLang、LMDeploy 做推理加速。另外它还有个 swift sample 命令,可以从大模型的接口做蒸馏采样来造训练数据——把「生成数据」这一步也收进了同一套命令行,这个设计我给好评。
第五拨:Web-UI。 swift web-ui 起一个 Gradio 界面,点点点就能配训练。我的判断是:拿它给团队里不做训练的同学演示流程够用,真跑任务还是回到命令行——参数多到 Web 界面里翻找不如写脚本可复现。
多模态这块也值得一说:图片、视频、音频混着训是它原生支持的,视觉塔和语言层的学习率还能分开控制, packed 训练把多模态样本打包提速。我翻了一圈 issue 区的多模态帖子,跑通的多,但图片分辨率、视频帧数这类预处理参数默认值偏保守,数据侧要自己压一压。
所以我的结论是:第一拨、第二拨和第四拨是真能用的活,第三拨看你的卡,第五拨当个门面。这个区分很重要,后面讲判断的时候还会用到。
一层壳的聪明之处,和它欠下的债
看它的架构,你会发现 ms-swift 自己没有发明轮子:底下是 transformers Trainer 加 peft 加 deepspeed,它做的是上面那一层命令行注册表、对话模板系统和数据格式适配。这个设计的好处显而易见——上游更新它跟得快,transformers 从 4.33 一路支持到 5.x,新模型发布基本是改个模板就能训。
但债也是这么欠下的。第一笔是依赖钉得死:datasets 要 >=3.0,<4.8.5,peft 要 <0.21,deepspeed 要 >=0.19.3,<0.20。这不是他们挑剔,是上游接口真在变,但对你来说意味着一个已经装了别的训练框架的 Python 环境里,十有八九要为它单独开一个 venv。我建议从一开始就习惯这件事,别硬塞进主环境。
第二笔是抽象税。训练完的 checkpoint 目录里有 args.json,下次推理它会自动回读所有训练参数,不用重复指定 --model——方便是真方便。可代价是排查问题时链路变长:你以为传了某个参数,实际它从哪一层读进去的,得翻半天。遇到要魔改训练循环、自定义 loss 的研究场景,这层壳的厚度就会从便利变成阻碍,这种情况下我会直接劝你绕过它去写 Trainer。
这里我有个不太一样的看法:社区里总有人说它「大而全等于胶水框架」,我不这么认为。对工程团队来说,训练、导出、部署、量化用同一套参数体系串起来,这个一致性省下的人力远超抽象税——你不用在四个工具之间对齐模型格式。真正被这层壳伤到的只有一类人:需要看清训练循环里每一步的研究者。工具没有错,错的是拿它的人不对。
装起来不难,难的是别踩版本
先老实交代:我这台机器是 MacBook,没有 N 卡,训练这步我没法在本机真跑。所以下面这些步骤和版本约束,是我对着官方 README 和中文文档逐条核过的,硬件数字全部注明出处,没有一个是估的。
安装本体就一行:
pip install ms-swift -U

# 或者用 uv,torch 后端自动匹配
pip install uv
uv pip install ms-swift -U --torch-backend=auto
运行环境官方给了明确表格:Python >=3.10(推荐 3.12),torch >=2.0(推荐 2.8.0),CUDA 推荐 12.8 或 13.0,transformers >=4.33。这张表是我见过写得最全的国产训练框架文档之一,连 flash-attn 和 vllm 的推荐版本都标了。
硬件门槛,官方口径分三档:
- 最低可用:单卡 24GB 消费卡(3090/4090 级别)。官方 Quick Start 原文写明:Qwen3-4B 做 LoRA 微调占 13GB 显存,单张 3090 十分钟跑完——这是官方原话,不是我的估算。
- 量化训练:7B 模型 QLoRA 官方标 9GB,一张 3060 12G 或者 4070 都能塞下。
- 建议配置:认真做对齐训练(DPO/GRPO)想要不憋屈,双卡起步;README 的 GRPO 示例里有 4 张 80G A100 跑 72B 混合模式的先例,量力而行。
Mac 用户别灰心,它支持 Apple MPS 和纯 CPU——但那是给你跑推理 demo 用的,训练别想。另外提醒一句磁盘:torch 一个包就两个多 GB,加上 Qwen3-4B 这种 4B 模型的权重本身就有 8GB 上下,缓存目录会跟着下载量膨胀,磁盘预留 30GB 起步比较稳,缓存位置提前用环境变量指到大盘上,别堆在系统盘。官方没给整机配置总表,哪些卡确定能用:NVIDIA 全系走 CUDA,AMD MI300 系走 ROCm,昇腾 NPU、摩尔线程、海光这些国产硬件也列在支持列表里,这个覆盖面在开源训练框架里相当少见。
照着官方那条路走一遍
官方 Quick Start 的例子选得很聪明:拿 Qwen3-4B-Instruct-2507 做「自我认知」微调,十来条数据就能让模型改口说自己是谁,反馈直观,最适合第一次上手。下面这套流程按官方文档原样走,我在没有卡的机器上把每条命令的参数都对着文档核了一遍,预期输出以文档描述为准。
先准备一个自我认知数据集,格式就是标准 messages 对话,存成 my.jsonl:
{"messages": [{"role": "system", "content": "你是朋友公司的售后助手"}, {"role": "user", "content": "你是谁?"}, {"role": "assistant", "content": "我是售后小助,专管轴承和润滑的行话问题。"}]}
然后一条命令开训:
CUDA_VISIBLE_DEVICES=0 \
swift sft \
    --model Qwen/Qwen3-4B-Instruct-2507 \
    --tuner_type lora \
    --dataset /path/to/my.jsonl 'swift/self-cognition#500' \
    --torch_dtype bfloat16 \
    --num_train_epochs 1 \
    --per_device_train_batch_size 1 \
    --learning_rate 1e-4 \
    --lora_rank 8 \
    --lora_alpha 32 \
    --target_modules all-linear \
    --gradient_accumulation_steps 16 \
    --max_length 2048 \
    --model_author swift \
    --model_name swift-robot \
    --output_dir output
几个参数说一下我的理解:swift/self-cognition#500 是官方自带的自我认知数据集,#500 表示采样 500 条;--model_author 和 --model_name 只在这个数据集存在时生效,分别决定模型「报户口」时的作者名和自己的名字。显存占用官方标注 13GB。
训完推理,--adapters 填训练输出目录里最后的那个 checkpoint 文件夹,不用再传 --model,它会从 checkpoint 里的 args.json 自动读:
CUDA_VISIBLE_DEVICES=0 \
swift infer \
    --adapters output/vx-xxx/checkpoint-xxx \
    --stream true \
    --temperature 0
按官方文档的说法,这时候问它「你是谁」,它会用你数据集里写的身份回答,而不是 Qwen 的自我介绍。想让它变成一个独立模型而不是挂在基座上的 LoRA,加 --merge_lora true 合并权重,再走 swift export --push_to_hub true 就能推回魔搭。整条路没有一步需要写 Python,这是我看完最直观的感受。
坑都在深水区
单卡 LoRA 这条主干道铺得很平,坑集中在两边:Qwen3 的思考标签,和分布式强化学习。
第一坑:Qwen3 的 think 标签。 issue #5507 有 33 条讨论,提问者问得很典型:SFT 数据集里没写 <think> 标签,训练后模型的行为是什么?这背后是个真实痛点——Qwen3 这类混合推理模型,训练数据里思考段的有无会直接影响输出风格,数据不干净的话训出来的模型一会儿思考一会儿不思考。这个 issue 下面社区给了不少实践建议,训练前务必把数据里思考标签的分布捋清楚。
第二坑:GRPO 训练超时。 issue #8053(bug 标签)描述的场景是 rollout server 明明拉起来了,训练端却报连不上 vLLM 的 51216 端口然后超时,21 条讨论里全是同类受害者。多机 RL 训练的网络配置比想象的脆,防火墙、网卡绑定、端口暴露任何一个环节都得自己检查。
第三坑:大模型流水线并行卡死。 issue #9451 更硬核:GLM 5.1 的 MoE 模型上 128 卡做流水线并行 LoRA,训练卡死在第一步,根因指向 Megatron 的 batch_p2p_comm 配置与 NCCL 懒初始化的相互作用。这个 issue 到我查的时候还挂着 bug 标签——说明 Megatron 这条路虽然通着,但边缘组合还是会有没填平的沟。
第四坑:同一模型不同后端向量不一致。 issue #6364 有 21 条讨论:同一个 embedding 模型,vLLM 部署和 swift 自带部署返回的向量对不上。做检索的同学要特别当心,训练和部署换后端之前先对一遍向量。
issue 区整体开着 600 个 open issue,看着吓人,但我翻了翻,响应速度不慢,中文提问也接待。高频讨论里还有一个值得单独说的:issue #4030,标题就是训练 Qwen3 系列的最佳实践,挂了 146 条讨论,从 MoE 结构的学习率设到 MoE 训练的数据配比,堪称半份公开的调参笔记。这种「官方出题、社区补答案」的长贴是 ms-swift issue 区的特色,动手前先搜一搜同类模型有没有现成贴,能省掉不少自己试错的时间。
社区之外的实战文章里,CSDN 上那篇从安装到推送的完整流程实测总结的几条跟 issue 区能对上:OOM 了按「开 gradient checkpointing → 转 bf16 → 换 QLoRA → batch 降到 1」的顺序处理;loss 不降先怀疑数据格式和模板匹不匹配,而不是猛调学习率;微调后模型变笨是灾难性遗忘,不是你训坏了。另一篇框架横评类的六款微调工具对比里给 ms-swift 的定位也跟我的判断一致:能力覆盖最全、偏命令行、绑定魔搭生态。公开的英文社区讨论不算多,Reddit 和 Hacker News 上少有成规模的讨论帖,这跟它用户集中在中文圈有关。
我最后的判断
值不值得上手,我给明确答案:如果你的训练对象是 Qwen、GLM、InternLM 这批国产模型,或者任务涉及多模态,ms-swift 是当下跟进最快、链路最全的选择,没有之一。新模型 Day-0 支持这件事,别人是真做不到这个速度——它是魔搭官方的基建,模型一发布它就有动力当天适配。命令行全链路的形态也适合要在训练和部署之间来回搬运模型的工程团队。
它不适合谁?两种人。第一种是要零代码体验的新手,直接去 LLaMA-Factory,它的 Web-UI 生态和社区教程厚度是同赛道最厚的,AWS SageMaker 这些平台的集成也更成熟——两家都是 Apache-2.0,换着用没有沉没成本,我的建议是新手从 LLaMA-Factory 入门、任务复杂了再迁到 ms-swift,模板和数据格式的思路是相通的。第二种是单卡抠显存到极致的玩家,Unsloth 手写的 Triton kernel 在省显存和提速上仍是独一档,7B 卡在 12G 里的场景它更对路;代价是模型覆盖窄、多卡能力弱。判断维度就三条:模型在不在它的支持列表、你有几张卡、要不要多模态——三条里命中前两条里的后者,就选 ms-swift。
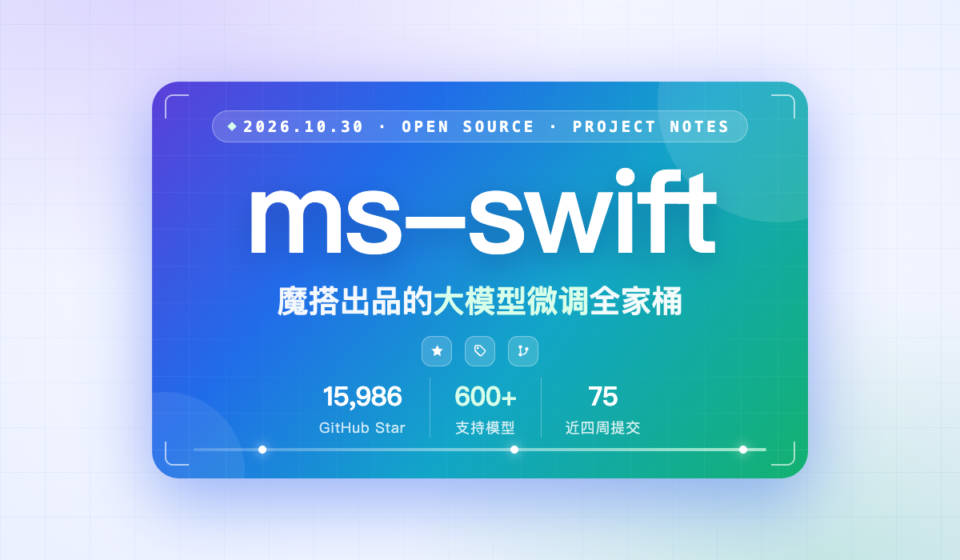
总而言之,这个项目我已经加进了自己的常用清单,下一块捡到的卡到手,第一个要跑的就是上面那个自我认知的例子。顺手拉了下它现在的数据:15,986 个 star,最新版本 v4.6.0 是 10 月 13 号发的,最近四周还有 75 次提交,十月底还在给新模型做当天适配——一个 2023 年 8 月立项的项目还能保持这个节奏,后劲是真的足。最后说句实在的,微调这件事的门槛这几年是被这类框架一寸寸压下来的,三年前我写 Trainer 脚本调模板的那一周,放到今天就是一条命令加十分钟等权重下载。你要是也有几百条攒着没用的对话数据,真的可以试试让它进到模型里,而不是永远躺在 prompt 里。