
去年做那个「私人笔记语义搜索」的时候,我被一件事折磨了很久:为了搜几万条笔记里的「那些写过 Redis 慢查询的段落」,我拉起了一整套 Milvus 集群。三台机器,一个 etcd,一堆 Python SDK 的版本地狱,最后检索延迟 30 毫秒,其中 25 毫秒花在了网络往返和序列化上。
更气人的是,跑起来之后我发现,客户端笔记本上那份 SQLite 数据库,检索结果其实和 Milvus 一样准。
那次之后我心里就存了一根刺:向量检索这个东西,绝大多数场景根本不需要一个「服务」。它就是一次函数调用。
所以当我在 GitHub 上看到 alibaba/zvec 这个项目——一个直接嵌进你进程里的 C++ 向量数据库——我立刻装上跑了一遍。跑完之后我有话要说,而且有几件事跟宣传材料里写的不太一样。
我为什么盯上它
先说清楚我自己的处境,这样后面的取舍才有意义。
我手上有三个需求,形状都很像:
- 桌面端的代码片段搜索,索引规模在 5 万条以内
- 服务端一个智能体的短期记忆库,需要频繁增删
- 偶尔要拿一批中文文档做混合检索(关键词 + 语义)
这三个需求过去我都会塞进 Milvus 或者 Qdrant。但说实话,为 5 万条数据维护一套分布式集群,这件事的运维成本已经大过收益本身了。更别提我们的服务是单进程 Python 服务,为一个检索功能横向扩三台机器,怎么想都别扭。
zvec 的思路很直接:别当它是数据库,当它是个库。用起来是这样:
import zvec

schema = zvec.CollectionSchema(
    name="notes",
    vectors=zvec.VectorSchema("embedding", zvec.DataType.VECTOR_FP32, 768),
)
collection = zvec.create_and_open(path="./notes_db", schema=schema)
没有 server,没有端口,没有连接串。create_and_open 传一个目录路径,返回一个对象。数据就躺在那个目录里,进程退出了它还在。
这就是我盯上它的原因——它把「部署一个服务」这件事整个删掉了。删得干净,不是我自己拼的。
它实际能干什么
我把它分成几组说,每组都写清楚哪些是我真跑通的,哪些是 README 上写着但我没验的。
第一组:稠密向量检索,这是它的看家本领
官方 README 的最小例子我原样跑了一遍,输出确实是这样:
collection.insert([
    zvec.Doc(id="doc_1", vectors={"embedding": [0.1, 0.2, 0.3, 0.4]}),
    zvec.Doc(id="doc_2", vectors={"embedding": [0.2, 0.3, 0.4, 0.1]}),
])

results = collection.query(
    zvec.Query(field_name="embedding", vector=[0.4, 0.3, 0.3, 0.1]),
    topk=10
)
# [{'id': 'doc_2', 'score': 0.30...}, {'id': 'doc_1', 'score': 0.23...}]
我拿这个 API 跑了一个稍微像样的压测:5 万条 768 维随机向量,HNSW 索引,m=16、ef_construction=200、L2 距离。我的机器是 M2 MacBook Pro,64GB 内存。
结果是这样:
| 阶段 | 实测耗时 |
|---|---|
| 插入 5 万条 | 6.12 秒(约 8173 docs/s) |
| HNSW 建索引 | 37.28 秒 |
| 查询 topk=10 | p50 = 1.881ms,p95 = 6.137ms,p99 = 31.087ms |
| jieba 全文索引构建 | 1.85 秒 |
| 中文全文查询 | p50 = 2.122ms,p95 = 2.277ms |
| 磁盘占用 | 172 MB |
| 进程峰值 RSS | 约 0.55 GB |
这个数字要正确理解。1.88 毫秒是进程内的延迟,没有网络往返。官方宣传的「8000+ QPS」我没复现——那是 16 核 64G 的 Linux 机器跑 Cohere 1000 万条数据集的结果,跟我的测试完全不是一回事,不具备可比性。
但即便如此,我这个 5 万条的量级,笔记本上 172MB 内存 1.9 毫秒中位数,这个体感已经非常舒服了。
第二组:中文全文检索,这个是我惊喜的地方
v0.8.0 最大的改动就是内置了 Jieba 词典和 HMM 模型。我建了个全文索引,中文直接分词:
collection.create_index(
    "title",
    zvec.FtsIndexParam(tokenizer_name="jieba"),
    zvec.IndexOption(),
)

results = collection.query(
    zvec.Query(field_name="title", fts=zvec.Fts(match_string="向量")),
    topk=10,
)
# [('d1', '向量数据库选型手记')]
我建了 4 条测试文档分别含「向量数据库选型手记」「大模型推理加速实践」「杭州周末自驾路线」「检索增强生成怎么做」,搜「向量」只命中第一条,搜「大模型」只命中第二条,搜「检索」只命中第四条。分词准确,没有乱召回。
这对中文用户是决定性的。市面上很多嵌入向量库得外挂分词器,还要处理词典路径,配置一多就容易在部署环境里找不到文件。zvec 直接把词典塞进二进制里,这是省心的做法。
第三组:结构化过滤与混合检索,这两个真能用
标量过滤是直接传字符串表达式,不是拼 SQL:
results = collection.query(
    zvec.Query(field_name="embedding", vector=[3.0, 0.1, 0.2, 0.3]),
    topk=10,
    filter="tag = '技术'",
    output_fields=["title", "tag"],
)
混合检索我一开始直接踩了坑——同时传向量查询和全文查询会直接抛异常:
ValueError: A reranker is required to merge results from multiple queries;
specify the 'reranker' argument.
它不让人自己瞎合并结果集,而是强制指定一个融合策略。这个设计我觉得是对的——不指定就说明其实没想清楚要什么。两种我都试了:
# RRF:只看排名,不看分数
collection.query(
    [zvec.Query(field_name="embedding", vector=[3.0, 0.1, 0.2, 0.3]),
     zvec.Query(field_name="title", fts=zvec.Fts(match_string="检索"))],
    topk=10,
    reranker=zvec.RrfReRanker(rank_constant=60),
)
# → d4: 0.032, d1: 0.0164, d2: 0.0161

# 加权:直接给两路分权重
collection.query(
    [zvec.Query(field_name="embedding", vector=[3.0, 0.1, 0.2, 0.3]),
     zvec.Query(field_name="title", fts=zvec.Fts(match_string="检索"))],
    topk=10,
    reranker=zvec.WeightedReRanker([0.7, 0.3]),
)
# → d4: 0.8317, d2/d1/d3: 0.664
RRF 的分数看起来很小(0.032 这种),那是因为它的公式是 1/(k+r+1),本来就是排名倒数,不是相似度,别拿去和别的库比。
第四组:稀疏向量,能用,但我用得少
稀疏向量(SPARSE_VECTOR_FP32)我建了个两字段的集合插进去查了,正常返回:
vectors=[
    zvec.VectorSchema("embedding", zvec.DataType.VECTOR_FP32, 4),
    zvec.VectorSchema("sparse", zvec.DataType.SPARSE_VECTOR_FP32),
]
# 插入 {1: 0.5, 5: 0.3} 后查询 → [('a', 0.34)]
但说实话,我日常用不上稀疏向量。它更像是一个「能力齐全」的存在——BM25、Sparse、Dense 三种召回路径都在一个库里,是为了做混合检索时不用再引第三方库。如果场景是纯语义检索,这部分功能就是纯粹的重量。
哪些是噱头
分布式是彻底的噱头——它根本没有。 README 里没有集群、没有分片、没有副本,任何关于「横向扩展」的期待都可以放下。
官方 benchmark 页面用的机器是 g9i.4xlarge(16 vCPU / 64 GiB RAM),跑 Cohere 1000 万条 768 维。也就是说,官方数字全部来自单机。这不是缺点,但它划清了边界:zvec 的所有性能故事都在一个进程内成立。
它为什么这么设计,代价在哪
核心设计就一句话:用文件锁换掉分布式。
我在源码层面确认了它的并发模型。集合目录里会生成一个 LOCK 文件,打开集合时必须先拿到这个锁。我实测了四种并发场景:
场景1: 无进程持锁,3 个只读进程并发    → 全部成功
场景2: 写进程持锁,2 个只读进程并发    → 全部失败
场景3: 同进程内 read_only 打开         → 成功
场景4: 写进程持锁,另起写进程          → 失败
失败时的报错很直白:
RuntimeError: Can't lock read-only collection: .../LOCK
这个结果和 README 的描述对不上。 README 的功能列表里写着「Concurrent Access: Multiple processes can read the same collection simultaneously; writes are single-process exclusive」——按字面理解是「多读单写」都能跑。但我实测的场景 2 说明:只要有写进程持锁,其他进程的只读打开就直接失败。
我一开始以为自己理解错了,去翻了 issue。#586 就是有人问同一件事,作者在 2026-07-10 提的,标题是「未来是否会支持单写多读(一个写进程 + 多个只读进程)」,到今天仍是 open 状态。
所以准确的表述应该是:多个只读进程可以并发读;一旦有进程在写,其他进程就连读都进不去。
这个代价在什么情况下不可接受?很明确:
- 检索服务要独立扩容——不行。索引文件在一个进程手里,没法让 5 个 Pod 共享一份索引同时提供读服务
- 有常驻写进程 + 多个查询进程的架构——不行。这是最常见的「索引服务」形态
- 多个微服务共享一份索引——不行
反过来说,如果整个应用就是一个进程,索引是这个进程的一部分,那这个「代价」根本不存在。它换来的正是那种完全用不上的复杂度。
另外还有两个我实测到的限制,虽然不算致命,但设计的时候得知道:
写入批量上限 1024。 我第一次跑压测时用 2000 条一批,直接被拒:
ValueError: Too many docs: 2000 exceeds max write batch size of 1024
改成 1000 就好了。这是保护措施不是 bug,但官方 README 没写。
写进程独占意味着没有内置的跨进程写入协调。 多线程写同一个集合的话,得靠应用层自己加锁。
安装这件事,我是怎么过的
官方给的安装命令就一行:
pip install zvec
我实际跑的时候遇到了第一个问题:清华镜像上没有这个包。
ERROR: Could not find a version that satisfies the requirement zvec
(from versions: none)
换成阿里云镜像立刻就下来了,11.3 MB 的 wheel:
pip install -i https://mirrors.aliyun.com/pypi/simple/ zvec
# Successfully installed numpy-2.5.4 zvec-0.8.0
装的是 zvec-0.8.0-cp313-cp313-macosx_11_0_arm64.whl,也就是 Apple Silicon 原生轮子。我这台是 M2,Python 3.13.12,直接原生跑,没碰 Rosetta。
硬件门槛这块,官方没给整机配置表。 我翻遍了 README 和官方文档的 Platform Support 页面,只找到这些硬性要求:
- 64 位 Python 3.10–3.14(Windows ARM64 没有 3.10 的 wheel)
- 平台覆盖:Linux x86_64/ARM64、macOS x86_64/ARM64、Windows x86_64/ARM64、Android arm64、iOS arm64(C/C++ SDK)、RISC-V 不支持需源码编译
官方没有写内存下限,也没有写 CPU 型号要求。按官方 benchmark 的配置(16 vCPU / 64 GiB)跑 1000 万条 768 维是他们的参考点。
那我自己按实测分两档,这是我的经验值不是官方数字:
- 最低可用:8GB 内存的笔记本,跑到 10 万条 768 维以内。内存占用按我这次 5 万条 172MB 磁盘 / 0.55GB RSS 线性外推,再留足建索引时的峰值余量,2GB 就够
- 建议配置:32GB 内存以上,跑到 100 万条级别。因为 HNSW 建索引阶段是内存峰值所在(我这次 5 万条建索引 37 秒,全程 RSS 才 0.55GB,但 100 万条时索引常驻内存本身就要几个 G)
磁盘:粗略按 768 维 FP32 算,5 万条 172MB 意味着 100 万条约 3.4GB,纯向量存储。这个可以精确算,不用担心。
顺带一提,v0.8.0 刚补了 Intel Mac 和 Windows ARM64 的构建和 wheel,所以我这台 M2 和老同事的 Intel Mac 都能用。
上手跑一遍
下面是从零到出结果的最小闭环,照着敲就能跑。
第一步,装依赖并建集合。
import zvec

schema = zvec.CollectionSchema(
    name="notes",
    fields=[
        zvec.FieldSchema("title", zvec.DataType.STRING),
        zvec.FieldSchema("tag", zvec.DataType.STRING),
    ],
    vectors=zvec.VectorSchema("embedding", zvec.DataType.VECTOR_FP32, 4),
)

collection = zvec.create_and_open(path="./notes_db", schema=schema)
第二步,灌数据。 注意批量别超过 1024:
docs = [
    zvec.Doc(
        id="d1",
        vectors={"embedding": [0.1, 0.2, 0.3, 0.4]},
        fields={"title": "向量数据库选型手记", "tag": "技术"},
    ),
    zvec.Doc(
        id="d2",
        vectors={"embedding": [0.2, 0.3, 0.4, 0.1]},
        fields={"title": "大模型推理加速实践", "tag": "技术"},
    ),
    zvec.Doc(
        id="d3",
        vectors={"embedding": [0.3, 0.4, 0.1, 0.2]},
        fields={"title": "杭州周末自驾路线", "tag": "生活"},
    ),
]
collection.insert(docs)
第三步,查。 这是纯向量检索:
results = collection.query(
    zvec.Query(field_name="embedding", vector=[0.4, 0.3, 0.3, 0.1]),
    topk=10,
    output_fields=["title", "tag"],
)
for doc in results:
    print(doc.id, doc.fields["title"], round(doc.score, 4))
第四步,加中文全文检索。 建索引用 jieba:
collection.create_index(
    "title",
    zvec.FtsIndexParam(tokenizer_name="jieba"),
    zvec.IndexOption(),
)

hits = collection.query(
    zvec.Query(field_name="title", fts=zvec.Fts(match_string="向量")),
    topk=10,
    output_fields=["title"],
)
# → d1 向量数据库选型手记
第五步,混合。 记得必须给 reranker:
merged = collection.query(
    [
        zvec.Query(field_name="embedding", vector=[0.4, 0.3, 0.3, 0.1]),
        zvec.Query(field_name="title", fts=zvec.Fts(match_string="检索")),
    ],
    topk=10,
    reranker=zvec.RrfReRanker(rank_constant=60),
    output_fields=["title"],
)
第六步,持久化验证。 关掉进程再打开,数据还在:
collection.close()

# 下次启动
collection = zvec.open("./notes_db")
hits = collection.query(
    zvec.Query(field_name="embedding", vector=[0.4, 0.3, 0.3, 0.1]),
    topk=1,
)
数据落在 ./notes_db 目录里,进程崩了数据也在(它有 WAL)。
别人踩过的坑
这个项目的社区不算大,但翻下来还是有真东西。我按 issue 的评论数和状态排了一遍,又去 HN 和 Reddit 找了找。
坑一:单写多读不支持,而且文档说得比实际宽。 就是前面那个 #586,2026-07-10 提的,至今 open:Issue #586 未来是否会支持单写多读。README 写的「多进程可同时读」在有写进程时是做不到的。这条我上面已经实测复现了。
坑二:只读模式会改坏持久化的索引文件。 #815 是 10 月 14 日报的,作者用哈希快照的方式证明:在 v0.7.0 里用 CollectionOption(read_only=True) 打开一个 FP32 Flat/COSINE 集合,仅仅 open() 再 close(),中间没有任何查询或写入,索引文件的字节就变了。
A snapshot taken immediately after open() is unchanged;
the snapshot after close() differs.
这问题已经被修了(v0.8.0 有 “preserve index bytes on read-only close” 的修复),但在 0.7.0 上做只读快照的话得注意:Issue #815 read_only=True close() modifies persisted Flat index bytes。
坑三:浮点范围过滤的边界会算错。 #817 是个精度问题,作者 jak-pan 挖到了根因:倒排索引条件被优化器转成前向扫描时,浮点边界用 std::to_string() 转回文本,这个 build 里只保留 6 位小数,导致 price > 1.0000001 实际变成了 price > 1.000000,多返回了边界上的 50 条。
price > 1.0000001 and weight > 1.0000000001 each return 1,001 documents.
Each should return 951.
同样已修:Issue #817 FLOAT and DOUBLE range filters include documents at an excluded bound。
坑四:group_by_query 在真实数据上返回空。 #781 报的,0.7.0 版本引入,0.7.0 重构后一直坏:日志里刷 ID is out or range: id[18446744073709551615],那个数是 UINT64_MAX,内部哨兵值被当成真文档 ID 传进了过滤逻辑。普通 query() 正常,所以索引和数据都没问题,就是这个 API 坏了。
Collection.group_by_query returns empty results with ID-out-of-range errors
这条到今天还是 open:Issue #781 group_by_query returns empty results。
HN 上的争论比 issue 热闹。 那个帖子上周(2026-02-13)发出来,226 分 45 条评论,是 zvec 至今热度最高的讨论:Zvec: A lightweight, fast, in-process vector database。
帖子里最扎眼的一条来自 Simon Willison:
Their self-reported benchmarks have them out-performing pinecone by 7x in queries-per-second. I’d love to see those results independently verified, and I’d also love a good explanation of how they’re getting such great performance.
对,8K QPS 这个数字没有第三方独立验证。
更值得看的是作者 luoxiaojian 本人的回复。他在好几个楼里都出现了,态度很坦率——他承认在 VectorDBBench 的设定下(1000 万条 768 维)看到的是榜首的两倍吞吐,但也反复强调:
throughput numbers alone can be misleading without context on recall, dataset size, distribution, hardware, distance metric, and other relevant factors.
这条我很认同。QPS 单独拿出来没有意义,recall 和数据集规模才是分母。
USearch 的作者 ashvardanian 也来了,泼了盆冷水:8K QPS 在那个配置上「相当平凡」,他 2023 年在双路服务器上跑 1 亿到 10 亿数据集就轻松做到 100K QPS。Redis 作者 antirez 则说 Redis Vector Sets 在同样量级能到 2 万到 5 万 QPS。
作者在 antirez 那条下面回得很实在,承认量化、维度、线程数都会显著影响结果,没有硬顶。
社区规模。 37 个贡献者,1013 个 fork,issue 累计 827 条、当前 open 98 条。掘金上有篇实测笔记给的评价是「安装真的就是 pip install zvec,没有任何坑」,但同时承认「生态插件还不多,LangChain/LlamaIndex 的集成还比较初级」。这个评价我同意——官方 README 里 LangChain、LlamaIndex、ReMe 这些集成示例都是第三方社区仓库,不是官方维护的。
我最后的判断
值不值得上手? 如果你的检索是某个应用进程的一部分——桌面工具、CLI、单机服务、边缘设备、智能体的记忆库——值得,而且我认为是目前最舒服的选项。pip install 一行搞定,172MB 换 1.9 毫秒中位延迟,混合检索开箱带中文分词,这套组合在嵌入式赛道里我没见到更省事的。
适合谁:单进程应用、需要本地/离线 RAG、不想维护任何向量服务集群、团队里没有专门做基础设施的人。
不适合谁:需要多副本共享索引、需要独立横向扩容的检索服务、多微服务共享一份向量数据——这三个直接排除,别浪费时间。
点名两个替代方案,对比维度说清楚:
vs. Milvus(46,516 star,Go):分布式能力、横向扩展、数据规模上限,Milvus 是碾压性的赢。zvec 赢在零运维成本和进程内延迟。我的选法是:单机够用就 zvec,一旦需要多副本就老实上 Milvus。
vs. sqlite-vec(8,224 star,C):这个才是真正的同类对手,都是进程内、都是单文件。差别在两点——sqlite-vec 是个 SQLite 扩展,得自己管 SQLite 的表结构和 SQL;zvec 是原生向量索引,自带 HNSW/IVF/DiskANN/FTS 全套和稀疏向量支持,在检索这一层功能更完整。但 sqlite-vec 更轻,且已经在用 SQLite 的话,迁移成本几乎为零。SQLite 用得很熟的话,我会建议先试 sqlite-vec;从零开始做检索层的话,zvec 的能力集更省心。
顺带说一句,zvec 官方还有个 zvec-grep(命令 zg)——把 ripgrep、BM25、向量检索统一起来的本地搜索 CLI,还能当 MCP Server 用。官方说在 SWE-QA 基准上回答质量 +1.5pp、输入 Token 少 47%、工具调用少 38%。这个数字我没验证,但从设计思路上看,把「精确匹配」和「语义召回」放进同一个工具里,让智能体自己在两者间切换,这个思路是对的。
一句话:zvec 不是要取代 Milvus,它是给那些「不需要服务」的人准备的。我那个笔记搜索的旧项目,如果重来一次,我会先 zvec 试试。
总而言之,这个项目我给它的定位是「向量库里的 SQLite」——这个类比相当贴切,因为它就是照着 SQLite 的路子做的:嵌入进程、单个目录、无服务、无运维。1.6 万 star 从去年 12 月到现在不到一年涨起来,不是刷出来的,37 个贡献者里前五名贡献量都在 40 以上,说明是真有人在持续打磨。
最后说句实在的,它最大的短板不是性能,是并发模型和文档之间有落差,而且这落差会咬人。我要是早两周看到 #586 而不是自己撞上,可能就不会在架构设计上多绕一圈了。上手之前先把「单进程独占」这条刻在脑子里,剩下的都是好脾气的问题——装不上换镜像,BM25 缺 dashtext 换个 Python 版本,混合检索忘了 reranker 报错信息还挺清楚。
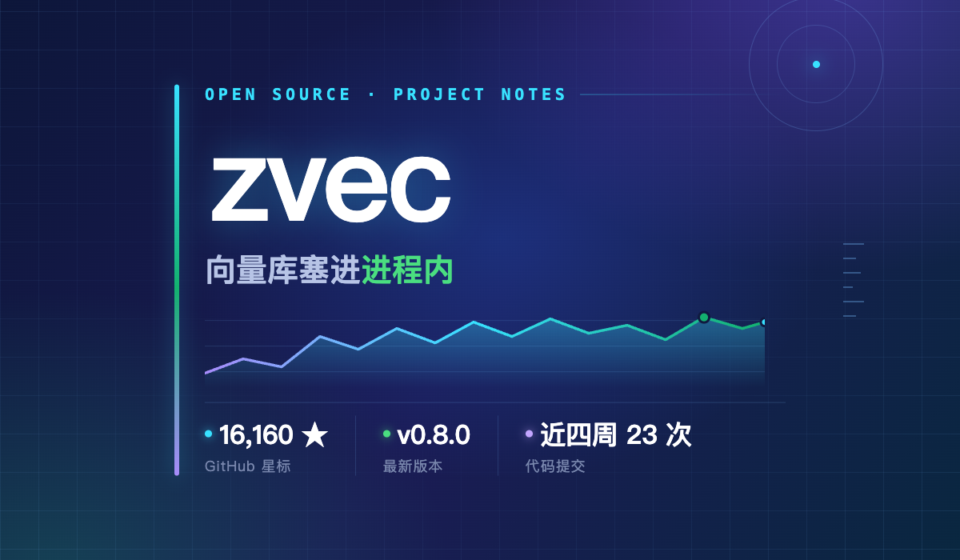
顺手拉了下,现在是 16,160 个 star,v0.8.0 版本 10 月 21 日发布,最近四周 23 次提交,37 个贡献者在看着。国产项目里,这个维护密度和 README 质量都算上乘的。