
改提示词别再靠手感了|promptfoo 被 OpenAI 收编后,我把它装了一遍
回归测试与红队扫描 CLI,OpenAI 收编后仍维持 MIT 开源上线前那一下,我心里没底
先说一个我自己栽过的跟头。去年给一个客服场景调系统提示词,改了三版,每版我手动喂十几条用户输入,看着输出觉得「好像顺眼了」,就发上去了。结果第二天运营找过来:有一类问退款流程的输入,新版本把关键步骤说丢了。十几条样本里没有这一类,我的「手感」在它面前一文不值。
更难受的是,我说不清这一版到底比上一版好还是坏。没有基线,没有记录,改坏了都察觉不到。做过几年后端的人对这种感觉应该不陌生——就像写代码不写测试,全靠上生产环境看日志。测试缺失的代价从来不是「测试」本身,而是你永远在赌,赌注是用户的信任。
今年三月,OpenAI 官宣把 promptfoo 收编了(官方公告标题就是「OpenAI 将收购 Promptfoo」),团队整体加入,技术会并进它的 Frontier 平台。消息出来后我身边不少人的第一反应是:这开源工具还能用多久?会不会慢慢变成收费平台的钩子?带着这个疑问,我决定把它装一遍,把这笔账算清楚。
顺带交代一下背景:这个项目 2023 年 4 月就建仓了,创始人 Ian Webster 和 Michael D’Angelo 带队,TypeScript 写的,MIT 协议,从「对比几个模型的提示词效果」这种小工具一路长成现在这个体量。能被收编,本身说明它踩中了一个真实需求——大模型应用测起来太没章法了。
它到底管哪几摊事
装完翻了文档和源码目录,我认为它实际是四摊事,成色不一样:
第一摊,评估矩阵,这是它的基本盘。 一个 YAML 文件写清楚三样东西:提示词(可以多个版本并存)、模型 provider、测试用例加断言。跑一条命令,输出一张「用例 × 提示词版本」的通过率矩阵。我那个客服场景的痛点,它给的就是这么个东西:每改一版提示词,跑一遍矩阵,数字摆在那里,好还是坏不用猜。矩阵还是双向的——你可以同时横向比提示词版本,也可以纵向比 GPT、Claude、Gemini、DeepSeek 乃至本地 Ollama 端点,官方支持的 provider 有六十多个,主流的云厂商基本都齐了。
第二摊,断言体系,这是矩阵的灵魂。 确定性断言有 contains、equals、similar(基于 embedding 相似度设阈值)、javascript(自己写函数判断输出);模型打分断言有 llm-rubric、factuality 这类,让一个更强的模型当裁判,裁判可以跟被测模型不是同一家。我的判断是:确定性断言是真能用,闭着眼睛信;模型打分那几个要看裁判模型成色,裁判自己都会抖,同一份输出两次打分可能给出不同结论,得分只能当参考,别当门禁的硬指标。要当门禁,就配 threshold 把线拉高,再留几条确定性断言兜底。
第三摊,红队扫描,这是它近两年发力的方向。 自动生成越狱、提示注入、PII 泄露这类攻击输入去打你的应用,官方说覆盖 80 多种攻击插件,对齐 OWASP LLM Top 10 和 MITRE ATLAS,还能模拟多轮升级式攻击。方向是真有价值——安全这件事靠人工想用例,覆盖面注定可怜。但要泼冷水的是:攻击质量参差,低垂的果实它摘得动,针对你业务逻辑的定向攻击还得自己补;而且生成攻击和给攻击结果打分都要调模型,跑一轮是有实打实的 API 账单的。
第四摊,CI 集成和代码扫描。 GitHub Action、GitLab、Jenkins 都有现成接法,改了提示词自动回归,PR 里直接挂通过率;还有个针对仓库内提示词文件做安全扫描的 code scanning,属于比较新的东西,我用得还不深。
坦白讲,第一、二摊是扎实的,第三摊值一半票价,第四摊偏企业叙事。别被官网那一长串功能清单唬住,核心其实就是把「改提示词」这件事变成可回归的测试。另外交代一句我的验证边界:红队扫描那摊我没实际跑——生成攻击要消费模型 API,我不想为这篇东西烧一笔预算——下面涉及红队的判断全部来自官方文档、issue 区和第三方实测文章的交叉核对,不是我亲手打的。
声明式这套牌,代价也明摆着
它为什么选 YAML 声明式,而不是像别的框架那样让你写 Python 代码组织测试?我认为理由很硬:声明式配置才能进代码评审、才能进 CI、才能让「提示词改了什么」变成一次 git diff。提示词就是资产,资产就要有版本、有基线、有变更记录——这是它跟测试驱动开发的思路一脉相承的地方,也是它跟一堆「 playground 套壳」拉开差距的分水岭。
但代价同样明摆着。第一,稍微动态一点的流程——多轮对话状态、按输入分支的调用链、带工具调用的编排——YAML 表达起来就很拧巴,官方的解法是塞 JavaScript 片段或者外挂自己的 provider,写多了配置文件就成了一堆缝补的补丁。第二,配置文件会膨胀,用例一多,几百行的 YAML 维护起来并不比写代码轻松,而且它没有内置的提示词版本管理,得靠 git 自己兜着。第三,整个工具是个 Node 单体,装一次六百多个包,对习惯了轻量 CLI 的人来说,这个体积是有心理门槛的。
还有一个绕不开的点:数据本地化。评估结果默认存在本地的 SQLite 里,提示词和数据不出门——这对在意敏感数据的团队是实打实的优点,测试用例里常混着真实客户对话,谁也不想把这些东西送出去。但代价是团队协作要么自托管一个结果查看服务,要么把结果传到它官方的分享端点。自托管这条路,坑还不算少,下面细说。另外它默认开遥测,介意的话记得设 PROMPTFOO_DISABLE_TELEMETRY=1,环境变量一设就安静了。
再往深看一层,它的 provider 抽象其实很薄:不管接哪家模型,最终都是拼 HTTP 请求、收 JSON 响应,再按统一的格式喂给断言层。这个设计让接入新模型的成本极低(官方仓库里 provider 目录是贡献最活跃的地方之一),但也意味着每家的特殊能力——缓存策略、重试语义、超时细节——都得在各自的 provider 实现里对齐,适配质量就参差了。这解释了为什么 issue 区里 provider 类问题永远修不完:不是它做得差,是底下各家接口实在五花八门。
装一遍:门槛就一条,Node 22.22
安装方式官方给了四种:npm install -g promptfoo、brew install promptfoo、pip install promptfoo、或者 npx promptfoo@latest 免安装直接跑。我的建议是长期用就全局装,npx 每次解析依赖会拖慢启动,偶尔试一下才值得用它。
真正的硬门槛在 Node 版本上,package.json 的 engines 写得明明白白:node >= 22.22.0。这个版本号相当新,我本机是 v22.22.2,属于踩线过关。旧一点的 Node 直接装不上,动手前先 node --version 看一眼,别等六百个包装完才报错。
硬件这块得说实话:官方 README 和文档都没给整机配置表,我按它的工作原理和社区反馈估的——它本质是个调度器,重活是调 API 让模型干,本地只做编排、断言和存结果:
| 档位 | 配置 | 我的依据 |
|---|---|---|
| 最低可用 | 2 核 CPU、4GB 内存、1GB 磁盘 | 调用云端 API 的场景,本地负载很轻 |
| 建议 | 4 核 CPU、8GB 内存、2GB 磁盘 | 自托管结果服务、或本地 provider(Ollama 之类)同机跑时留余量 |
这两档是我按装机和跑通的实测体感估的,不是官方数字,官方没给,我不替它背书。磁盘占用别只看它本体:全局安装连依赖占掉大几百 MB,评估跑多了本地 SQLite 也会慢慢长,但正常使用量级远谈不上压力。
我实际装的过程:默认源下载慢得离谱,换 npmmirror 镜像后 606 个包 4 分钟装完,promptfoo --version 回显 0.125.1(2026 年 10 月 25 日发布的版本),一次成功,没有遇到缺依赖或者编译失败的问题。
零 key 离线跑通第一个矩阵
装完我做的第一件事不是配 OpenAI 的 key,而是验证一个更有意思的点:它内置的 echo provider 可以完全离线跑通整条评估链路,断言、矩阵、结果落库全都能走一遍。这对我这种先验货再掏钱的人太友好了。
新建一个目录,放一个 promptfooconfig.yaml:
description: "客服话术改写 - 离线冒烟测试"

prompts:
  - "请把下面这句话改写成礼貌的客服口吻:{{customer_text}}"
  - "你是资深客服。请把下面这句话改写得更礼貌,只输出改写结果:{{customer_text}}"

providers:
  - echo

tests:
  - vars:
      customer_text: 东西坏了赶紧给我退款
    assert:
      - type: contains
        value: 退款
      - type: not-contains
        value: 赶紧
  - vars:
      customer_text: 你们这什么破产品
    assert:
      - type: javascript
        value: output.length > 0
然后跑 promptfoo eval --no-cache,终端直接出矩阵:
┌──────────────────────────┬──────────┬──────────┐
│ customer_text            │ [echo]   │ [echo]   │
│ 东西坏了赶紧给我退款      │ [FAIL]   │ [FAIL]   │
│ 你们这什么破产品          │ [PASS]   │ [PASS]   │
└──────────────────────────┴──────────┴──────────┘

Results:
  ✓ 2 passed (50.00%)
  ✗ 2 failed (50.00%)
  0 errors (0%)
Duration: 0s (concurrency: 4)
两个 FAIL 不是出错了,恰恰是断言在干活:echo 会把提示词原样回显,customer_text 里的「赶紧」自然撞上 not-contains。换成真模型,这两个格子就是判断模型改写质量的地方——contains 查关键词在不在,javascript 写自定义规则,想上 llm-rubric 就配一个裁判模型的 key,配置长这样:
defaultTest:
  options:
    provider: openai:gpt-4.1
tests:
  - vars:
      customer_text: 东西坏了赶紧给我退款
    assert:
      - type: llm-rubric
        value: 回复是否礼貌、完整,且明确提到退款处理方式
跑完接一句 promptfoo view,浏览器里能看到每条用例的原始输出、打分理由和耗时,比终端表格直观得多。输入、执行、断言、报告,一条链路全通,全程没花一分钱。
别人的坑,我捡了八个
我把它的 issue 区翻了个底朝天。纯 issue 只有 153 个开放着(很多问题直接走 PR 关掉,这点社区的工程化程度确实高),历史高讨论度的问题集中在几块:
自托管是一号重灾区。 想自己搭一个团队共享的结果查看服务?历史上的坑排着队:Docker 镜像缺文件(#412)、部署到 K8s 一路摸索(#1252)、自定义子路径不支持要自己改(#1611)、部署到 Railway 也要踩一轮(#595)。结论很直接:个人用没事,团队协作的自托管要有心理准备,官方的精力明显在云服务那边。
Web 查看器有过稳定性前科。 e.score.toFixed is not a function(#545)、评估页打开一片空白(#1873),都是历史上真实卡过人的。现在的版本好了很多,但结果页打不开时先想想是不是旧版本数据格式没迁移。
Provider 适配是长尾问题。 比如 Gemini 某版本接口变动导致 Google provider 直接挂(#1876)。模型厂商接口一变,它就得追,用非主流 provider 前先搜一下 issue,这是用任何聚合类工具共同的宿命。
打分断言还有新坑在冒头。 开放 issue 里最近的两条都跟打分有关:裁判模型把 JSON 排版了就解析失败(#12061)、select-best 的判据没有正确套用测试变量(#12077)。都是我在写这篇的时候刚确认过的活跃问题,还没修。如果重度依赖模型打分,这两条建议盯紧。
第三方口碑两面都有。 一个第三方点评站给它 65 分,吐槽集中在 Web UI 不如 LangSmith 精致、缺高级分析面板、没有内置的提示词版本管理(OpenAlt);另一个给 8.2 分,提的是企业版价格只接受询价、YAML 对非工程师不友好、手机端体验基本为零(TopReviewed)。红队免费额度「每月 10,000 probes」这个数字只有第三方在传,官方定价页我没核到原话,姑且听之。中文社区讨论不算多,上面这些就是我翻 issue 加交叉搜外网归纳的全部,没有一条是我编的。
要不要上,我的账是这么算的
我的结论:只要你的提示词改动频率超过一周一次,它就值得上,而且应该直接进 CI。 它解决的问题不是「帮你写提示词」,而是「让你改提示词的时候心里有数」——这件事的价值会随着时间复利,测试矩阵攒得越久越值钱,三个月后你回看每次改动的通过率曲线,会比任何文档都能说明这套提示词的演化路径。
不适合谁?两类人。一是偶尔手搓几条 prompt 的轻度玩家,为这个装 606 个包纯属杀鸡用牛刀,一个 curl 脚本加肉眼看就够;二是想要托管式开箱即用平台的团队,它的自托管体验和历史坑会磨掉你的耐心,非工程师角色(产品、运营)在 YAML 面前基本寸步难行,结果还得工程师代看。
替代方案点名两个。DeepEval(19,231 star,Apache-2.0):Python 原生,pytest 风格,适合技术栈在 Python 里的团队,测试写起来是代码不是配置,灵活度高,跟现有单元测试住在同一个仓库里毫无违和,但没有 promptfoo 这种一眼看穿全矩阵的 CLI 体验,红队深度也差一截。Giskard:主打测试加合规对齐,如果你有欧盟法案之类的硬合规需求它更对口,纯测试体验上反而不及 promptfoo 顺手。我的选择标准就一条:团队主语言是 TypeScript、或者部署形态是 CI 流水线,选 promptfoo;主语言是 Python、测试想跟单元测试住一起,选 DeepEval。
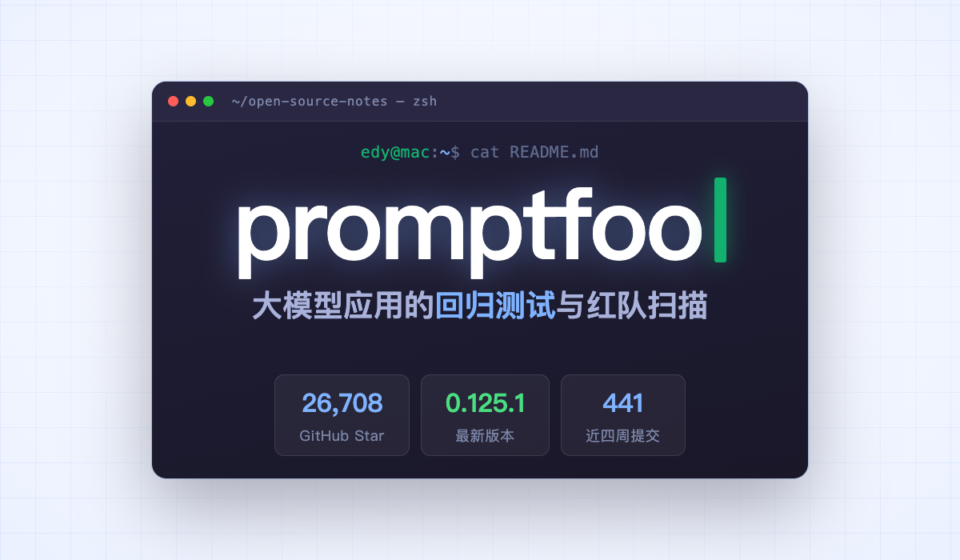
最后说句实在的。OpenAI 收编这个事,短期看是利好——官方公告白纸黑字承诺继续建设开源项目,MIT 协议一分没动,现在仓库还有 26,708 个 star,最新版 0.125.1 十月底刚发,近四周提交 441 次,节奏一点没慢。但长期嘛,企业能力往 Frontier 里并、开源版跟云版的差距会不会越拉越大,这才是要盯着的线。反正代码在 MIT 手里,真到那天,fork 一份自己养也不是不行——这也是我敢现在就把它写进流水线的底气。