
AI 编程 Agent,从 Gemini CLI 分家两年一条还在群里传的攻略,和一扇已经焊死的门
上礼拜有个朋友在群里转掘金那篇《每天 2000 次免费请求》的攻略,说装个 Qwen Code,OAuth 登录就能白嫖,让我也试试。我当时顺手点开官方文档对了一遍,愣了半分钟:那套 OAuth 免费通道,2026 年 4 月 15 日就停了。官方原话写得很干脆——它不再是 /auth 菜单里的选项,缓存 token 短暂还能跑,新请求一律拒掉。攻略还在群里传,门已经焊死了。
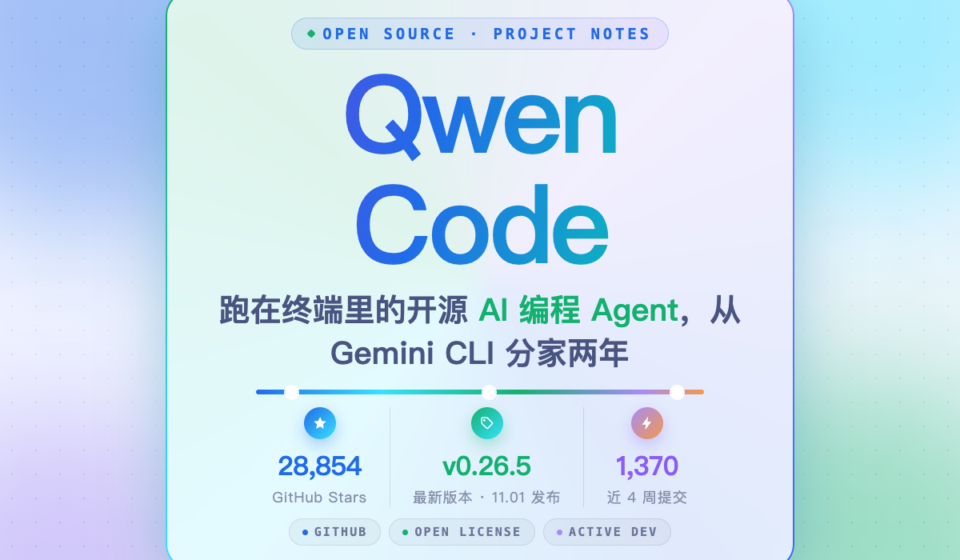
这事让我对 Qwen Code 本身来了兴趣。一个项目的攻略和它的现状脱节半年,通常有两种可能:要么项目凉了没人管,要么它迭代太快,写攻略的人跟不上。Qwen Code 显然是后者——我去仓库翻了翻,最新版 v0.26.5 就是 11 月 1 日早上发的,最近四周合着有 1,370 次提交,open 状态的 issue 堆了 2,069 个。一个 2025 年 6 月底才建仓的项目,一年多冲到 28,854 个 star,这个速度放在 AI 编程工具这个卷出天际的赛道里,不算 quietly growing,算 loud。
我自己的处境是这样的:Claude Code 好用,但一个月 20 刀起,绑死 Anthropic 一家;Gemini CLI 免费,模型在写代码这件事上总差口气;OpenCode 之类的不绑厂商,可功能铺得没 Claude Code 开。我想要的是 Claude Code 那套 subagents、skills、hooks 的干活方式,但后端模型我想自己挑——付费 API 也好,公司内网的 vLLM 也好,本地 Ollama 也好。Qwen Code 的 README 就冲着这个诉求来的:框架开源,模型随插随换。装不装得上这个承诺,我打算亲手验一遍。
拆开看,哪些是真本事,哪些还热着
先把最硬的部分说了。Qwen Code 的核心是终端里的 coding agent:文件读写、shell 执行、plan mode、git worktree、sandbox,再加 MCP、LSP、hooks 这些现在算是标配的扩展点。README 里有一张和 Claude Code 的逐项对照表,从 SubAgents、Agent Teams 到 IDE 插件、headless 模式,两边全打勾,最后三行是 Qwen Code 独有的:模型和框架都开源、多协议、还有个 Agent Arena。
这些勾我当然不能照单全收,所以拆开装好的包自己翻了。验证过的:全局装完后,包里 bundled/ 目录下整整齐齐码着 17 个内置 skill,每个都有独立的 SKILL.md——review、batch、loop、autofix-pr、stuck、coordinate、workflow-authoring 这些都在,不是 README 画的饼。Agent Arena 也一样,我在打包产物里能直接搜到 ARENA_SESSION_STARTED、ARENA_AGENT_TOKENS 这类遥测事件定义,功能是真实落了码的,不是 PPT 功能。这个 arena 挺有意思:/arena 一条命令,最多五个模型在各自的 git worktree 里赛跑做同一个任务,跑完出对比,你只保留赢家的代码。多模型 PK 这件事,Claude Code 到现在也没有。
多协议是这个项目我最看重的一层。/auth 走一遍能看到四个大项:QwenCloud(阿里自家)、Alibaba ModelStudio(含按月的 Coding Plan 和按量的 Token Plan)、第三方(DeepSeek、Kimi、OpenRouter 这些预置好了)、Custom Provider(OpenAI、Anthropic、Gemini 三种协议任填端点)。也就是说 Ollama 起个本地服务,填个 base URL 就能接上,模型切换在会话里 /model 就行,不用重启。
hooks 和 MCP 的接入方式也顺手说下,这两个是把 CLI 变成团队工具的关键。hooks 走 qwen hooks 命令或者会话里 /hooks,能在工具调用前后插自己的检查逻辑——比如「每次写文件之前先跑一遍 lint」「提交前强制过测试」,这正好是对付高自治 agent 翻车的缰绳。MCP 就是标准姿势,qwen mcp 管理服务器,配 JSON 就挂载,连我们公司内部的线索系统这种 SSE 端点都能接。工具链是开放的,不是围着自家模型转的封闭花园,这一点比很多「开源」壳子实在。
没验过的我也直说:Desktop 桌面端、qwen serve 起的 Web UI(README 自己标了 experimental)、VS Code / JetBrains / Zed 插件,还有 Telegram、钉钉、微信、飞书这些 IM channel——命令和文档都在,但我这次只装了 CLI,这些门我没挨个推开。另外有个小彩蛋:那 17 个 skill 里有个 zvec-grep-install,是给项目装阿里自家向量检索工具 zvec 的——巧了,这工具我前阵子刚写过,阿里把自家生态往这个壳子里塞的意图相当明显。
从 Gemini CLI 分家,既是自由也是代价
Qwen Code 不讳言自己的出身:fork 自 Google Gemini CLI v0.8.2,README 结尾专门感谢了 Gemini 团队。但从 v0.1 开始就不再同步上游,彻底独立发展。这个出身值得说两句,因为它直接决定了后面的取舍。
第一层代价是广度换深度。支持四种协议、任意 provider 听着美好,但文档的重心明显压在 Qwen 自家模型上。想接一个不在预置清单里的端点,就得手写 ~/.qwen/settings.json 里的 modelProviders,格式对不对文档讲得含糊;有第三方上手文章提到,早期那种把模型包在 { protocol, models } 里的旧配置格式,新版会静默跳过——不报错,就是不理你。这种坑最耗人,你以为是模型不行,其实是配置没被读进去。
第二层代价是自治带来的失控风险。agent 越自主,翻车越无声。open 的 bug 里有个我很在意:issue #10887,工具调用反复报错时没有早停机制,会话会在死胡同里空转,一个 session 烧掉 5 到 14M token。我在自己的使用习惯里给它加了一条铁律:yolo 模式绝不开在有未提交改动的仓库里。这不是我多虑,下面坑那一节有个 HN 网友的教训比我狠得多。
至于效果,官方给了个 SWE-bench Verified 的数字:七个版本的 Qwen Code 用同一个 Qwen 3.7 Max 模型跑,平均分落在 76.40% 到 77.80% 之间,500 个任务、每版本三次。这个数我没有条件复测,只能当官方口径参考——但它至少说明了一件事:从 0.0.14 到 0.22 七个版本,分数几乎是一条平线。框架狂奔半年,能力上限其实被模型摁着,这反过来印证了我上面的判断:这工具的上限,取决于你给它接什么模型。
装它只要两分钟,门槛全在装完之后
安装本身没任何故事。我走 npm:
npm install -g @qwen-code/qwen-code@latest
qwen --version
# 0.26.5
实测下载加安装两分钟,17 个依赖包,没报一个错。不想用 npm 的还有两条路:macOS 上 brew install qwen-code,或者官方一键脚本(Linux/macOS 一条 curl | bash,Windows 一条 irm | iex)。装完记得重开终端让环境变量生效。
硬件门槛官方没给整机配置表,README 里唯一的数字要求是 Node.js 22 以上——这个要当真,有第三方文章提过老版本 Node 会出现「安装能过、启动就崩」的情况,报错还不指向版本问题。我本机是 Node 22.22.2,一次通过。除此之外,CLI 本身就是个 Node 进程,内存占用和普通前端工具链一个量级,真正的算力开销全在云端模型那边,你本机不需要任何 GPU。如果你想走本地模型路线,显存账要算在 Ollama 那头:HN 上有用户拿 32GB 内存的机器跑 Qwen3 Coder 30B(MoE,激活 3B)做日常编码,结论是「写定义清晰的任务够用,架构层面的活还差着」。所以两档配置我这么给:
- 最低可用:任意能跑 Node 22 的电脑 + 一把第三方 API key(DeepSeek、Kimi 都行),本机 8GB 内存都绰绰有余,成本全在 token 上;
- 建议配置:16GB 内存的常规开发机 + Coding Plan 或按量 Token Plan 走 Qwen3-Coder 系列,这是文档和生态对得最齐的组合;想全本地,先把 32GB 内存或同级显存备好,再谈体验。
key 的注入方式也交代清楚:CLI 参数优先级最高,其次系统环境变量,再次项目目录里的 .env 文件,最后才是 settings.json 的 env 字段。日常我建议走 .env 加 .gitignore,CI 里走环境变量注入,别把 key 写进任何会被提交的文件。限流焦虑重的,再把 --fallback-model 配上,429 的时候自动切备用模型,不至于一个高峰期干等。
我真跑通的部分,和停在 /auth 的部分
装完我干的第一件事是确认基本盘:
qwen --help
输出很长,但有两个细节值得停一下。一是 qwen auth 这条老命令被明确标了 (removed)——和文档说的对上了,老攻略里让你敲这条命令的,现在敲出来就是个删除提示。二是 headless 模式的参数铺得很开:-p 非交互执行、--approval-mode 五档审批(plan / default / auto-edit / auto / yolo)、--fallback-model 给 429 限流兜底、--sandbox 能选 docker 或 macOS 自带的 sandbox-exec。工程化的小心思不少。
然后我试着直接跑一个真实任务——建了个目录,放一个故意写错的 Python 文件进去(add 函数返回的是减法),用 --bare 模式让它修:
qwen --bare "把 buggy_calc.py 里的 bug 修掉"
输出是一行明确的拒绝:
No auth type is selected. Please configure an auth type
(e.g. via settings or `--auth-type`) before running in
non-interactive mode.
报错本身挺友好,没甩堆栈,直说缺认证。但这就是我停下来的地方:再往下要走模型调用,就得有一把能用的 key。OAuth 免费通道已经关了,阿里自家的 Coding Plan 和 Token Plan 都要掏真金白银,我不想为了写这篇专门开一个月付。所以端到端那一步——它读文件、改代码、跑测试的完整闭环——我是按官方 Quick Start 的流程走的:cd 进项目目录敲 qwen,会话里 /auth 选 provider 填 key,然后丢一句 “Explain this repository and show me where to start”,官方说它会先扫仓库结构再给上手路径。流程本身简单,卡点只在那把 key。这一段我没跑通就是没跑通,读者里要是已经有 key 的,麻烦在评论区补一刀实测。
别人交过的学费
- 最贵的一课来自 HN。用户 nurettin 的原话:”I don’t recommend it for code editing unless you’ve committed your code. It destroyed a lot of files in just 10 minutes.”——没提交就放手让它改,十分钟毁一堆文件。这条和我上面说的 #10887 死循环烧 token 是同一个病根:agent 自治越深,越要有 git 提交点和审批档位兜底。我的规矩是
--approval-mode起步用 default,文件改动用 auto-edit,shell 命令永远留人审。 - 长上下文会明显变慢。掘金那篇(现在额度部分已过期,但体验部分还作数)提到 256K 上下文塞满后响应从三四秒掉到十五到二十秒,用
/compress压历史能缓解。我自己没跑大仓库对比,这条引自他们的实测,链接在文末。 - macOS + tmux + 中文输入法是盲区。issue #8177 报了光标错位和输入乱码,在 tmux 本地会话里用 IME 时触发。习惯在 tmux 里干活的中文用户大概率会撞上,先知道有这回事,省得怀疑自己键盘坏了。
- 老配置静默失效。前面说过,旧版
modelProviders格式会被新版直接跳过、不报错。另外security.auth.apiKey、security.auth.baseUrl这几个字段也弃用了,qwen auth命令整个移除。从老版本升上来的,配置文件先别急着骂工具傻,先怀疑自己的写法过时了。 - 空目录启动等于白玩。这是第三方上手文里提的,我认可:它的一切价值都建立在当前目录的代码上下文上,在空文件夹里启动,它就只是个套着壳的聊天机器人。
- 本地模型配置全靠手。有上手文章数过,向导式配置接本地模型要点七步——地址、占位 key、模型名一个个填。其实一条
modelProviders配置就能搞定,但文档没把这条捷径放在明面上。 - 公开讨论的整体水温:HN 上有用户当年就是冲着「每天 2000 次免费」用的它,免费通道关了之后抱怨归抱怨,留下来的理由变成了「多协议 + 开源」;saas.pet 那篇九天实测的结论是拿 Qwen3-Coder 跑成本敏感的活(比 Claude Sonnet 便宜约三倍)、难活切 Claude——这个用法跟我心里的方案几乎一致。也有不留情面的,同一条 HN 帖子里有人说它是 “carbon copy of gemini cli”,得哄着才能干活。口碑两极,但两极的理由都很具体。
我现在的用法,和两句实话
值不值得上手,我的答案分人。
适合:已经有任意一家的 API key、想要 Claude Code 那套 agent 工作流又不想被单一厂商绑住的;中文注释、中文 commit message 场景为主的团队(Qwen 系模型在这块的优势是真实的);想全链路私有化的公司——框架 Apache-2.0,模型开源权重,vLLM 一架,数据不出内网,这条 Claude Code 给不了。
不适合:冲着「免费午餐」来的——门焊死了,现在最便宜的正规路子是第三方家的低价 key,白嫖心态趁早放下;还有仓库常年不提交、习惯裸奔的——对这种工作流,任何高自治 agent 都是风险放大器,先改习惯再谈工具。
顺便算笔成本账,免得有人被「开源」两个字带偏。框架开源等于零 license 成本,但 token 是实打实的钱:按第三方上手文的口径,重度一天干下来,第三方低价模型大概几块到十几块人民币,阿里按量 Token Plan 的同工作量花费会再高一档,Coding Plan 则是固定月费换安心——我上面说的「比 Claude Sonnet 便宜约三倍」来自 saas.pet 的实测口径,具体差多少,取决于你的代码库大小和会话长度,别人替你算不了。
替代方案我点名两个。Claude Code:质量上限和省心程度仍是第一档,代价是每月 20 刀绑死 Anthropic,多协议想都不用想;如果你预算无压力、要的是稳定输出而不是自由度,直接用它,别折腾。aider:走的是另一条路,无 agent 编排、git-native、轻量到像个 pair programming 脚本,适合改改脚本、写写小功能的场景;但你要 subagents、skills、arena 这些编排能力,aider 没有这一层。选型就一句话:要自由度和编排,Qwen Code;要质量下限,Claude Code;要轻快,aider。
一句话收尾:Qwen Code 是那个把「Claude Code 的工作流」和「模型自由」这两个愿望同时接住的开源答案——前提是你自己付模型的账单。顺手拉了下它今天的数:28,854 个 star,最新版 v0.26.5 今天早上刚发,最近四周 1,370 次提交,热度一点没降温的意思。至于那篇「每天 2000 次免费」的攻略,替我转告群里还在传的朋友:它过期了,别再照着敲了。
参考与出处:
- 仓库与数据:https://github.com/QwenLM/qwen-code(star 数、release v0.26.5、近四周提交数,均取自 GitHub API 实时数据)
- 认证文档(OAuth 停用声明):https://qwenlm.github.io/qwen-code-docs/en/users/configuration/auth/
- issue #10887(死循环烧 5-14M token):https://github.com/QwenLM/qwen-code/issues/10887
- issue #8177(macOS + tmux IME 光标错位):https://github.com/QwenLM/qwen-code/issues/8177
- HN 讨论档(nurettin 毁文件、”carbon copy” 评价):https://news.ycombinator.com/item?id=44934283 、https://innerself-hn.com/item?id=45083582
- saas.pet 九天实测:https://saas.pet/reviews/qwen-code-review
- azbot 实测(Coding Plan 定价、本地模型七步配置):https://www.azbot.com/143959380/qwen-code-cli-review-2026-up-to-five-models-race-and-the-winners-code-is-kept
- standardcompute 测评页(弃用字段与静默跳过问题):https://standardcompute.com/best-ai-agent/qwen-code
- 掘金体验文(长上下文延迟、/compress):https://juejin.cn/post/7639583242592682034
- 第三方上手文(Node 版本坑、空目录问题):https://www.iqilian.com/guide/qwen-code-shangshou-kaiyuan-pingjia-cli