
上个月同事让我帮他改一段浏览器自动化的脚本,用的是 browser-use 的 0.x 写法:Agent(task=...) 加一堆 max_actions_per_step 之类的调参项,配一个 ChatOllama。我照着他发我的旧博客调了半天,接口对不上,报错信息里还夹着一句没见过的英文。后来才发现,不是他抄错了,是这库自己换了引擎——browser-use 在 1.0 把整套执行模型推倒重写了,而网上流传最广的那批教程,全是 0.x 的。
1.0 换了执行引擎这事让我起了兴趣。一个 12 万 star 的明星项目,换代换得这么狠,官方文档里那句「releases move fast and can break APIs」到底意味着什么?我把它装了一遍,又用本机的 Ollama 真跑了一个最小任务,下面把账算给你看。
换代换得有多狠
先说清楚 1.0 到底改了什么。0.x 时代的 browser-use,每一轮把页面 DOM 结构整理成文本喂给模型,模型从一份动作清单里挑一个(点按钮、填表单、滚动),执行,再看新页面。1.0 换了个思路:模型不再挑动作,而是直接写一段 Python,在一个持久的 REPL 里跑,底层走的是 Chrome DevTools Protocol(CDP),构建在 Pydantic AI 上。仓库首页那句话说得挺直白:模型、一个 REPL、CDP,这就是整个智能体。
这个变化对使用者意味着两件事。第一,0.x 的主接口(Agent、Browser、Tools、run()、final_result())保留了,但一大批调参项被砍掉了:max_actions_per_step、flash_mode、planner 相关的一整组、history 重放、pause()/resume(),官方迁移文档里列了整整三张表。第二,provider 类被清理了,ChatOllama、ChatDeepSeek、ChatGroq 这些直接 import 会报 ImportError,错误信息会告诉你替代写法。我装完 1.0.5 亲手试了一次:
from browser_use import ChatOllama
ImportError: browser_use.ChatOllama was removed in browser-use 1.0.
In 1.0: ChatOpenAI('<model>', base_url='http://localhost:11434/v1', ...)
旧参数也没死透,而是降级成警告。我传了个 0.x 教程里最常见的 max_actions_per_step=5,它打印一行「ignored in browser-use 1.0: each step is one Python cell」然后照常跑。这个处理方式我挺欣赏——不静默吞掉,也不一棒子打死,迁移期体面。
再往深想一层,这个设计是有明确代价的,而且我认为官方自己心里有数。0.x 那套「DOM 快照加动作清单」,每一步模型做了什么、点了哪个元素,日志里一目了然,出了错你能精确归因到第几步第几个动作。1.0 换成模型自由写代码之后,一个 cell 里可能塞了导航、点击、读取、判断一整套逻辑,可审计性是实打实下降了。官方用两样东西补:一是 judge 机制,跑完让另一个模型对着轨迹打分、标出 prompt_injection_detected;二是结果对象里的 result.messages,保留了完整对话轨迹。但补丁终究是补丁——如果你的场景要过合规审计、或者要求每一步可复现可回放(0.x 的 history 重放 API 就是干这个的,1.0 直接砍了),这个代价就不可接受。另外自由写代码意味着模型出错的方式也升级了:从「点错按钮」升级成「写出一段有副作用的代码」,权限收敛比以前更重要。
但真正的坑在别处。网上那批 0.x 教程的完整代码,大概率跑不动了:要么 import 报错,要么参数被警告忽略、行为跟你预期的不一样。官方给的出路是锁版本——pip install 'browser-use<1' 还能继续用 0.x,或者 browser-use==1.0.6 精确锁新版。README 里反复强调用 == 不要用 >=,这个版本号更新的速度配得上这个警告:11 月 13 日发 1.0.4,14 日发 1.0.5,16 日凌晨发 1.0.6,三天三个版本。顺带一提,我写这篇的当天早上,PyPI 上最新的还是 1.0.5,1.0.6 只在 GitHub 发布了——发版流水线自己都在追进度,你更该锁死版本号。
新引擎的实际账目
能力层面,我把 README 和迁移文档对完之后的判断是这样的:
真能打的。一是本地浏览器接入的模式很全:Browser('chromium') 起一个带独立临时配置的全新 Chrome,跑完就删;Browser('chrome') 直接接管你已经开着的 Chrome,登录态都在;还能复制你某个 Chrome profile 的副本给智能体用。二是 sensitive_data 的域名作用域写法,密码只在你指定的域名上输入,输出里统一替换成 <secret:name> 占位符。三是自定义工具就是普通 Python 函数加装饰器,没有仪式感。四是结构化输出,output_model_schema=MyModel 拿到的就是 Pydantic 对象,不用自己从文本里抠。后两条我各给一段真实能跑的代码,先是自定义工具加域名白名单的组合:
from browser_use import Agent, Browser, Tools

tools = Tools()

@tools.action("把价格写入本地表格")
def record_price(item: str, price: str) -> str:
    with open("prices.csv", "a") as f:
        f.write(f"{item},{price}\n")
    return "ok"

agent = Agent(
    "去 example.com 查价格并记录",
    tools=tools,
    browser=Browser("chromium", allowed_domains=["example.com"]),
)
allowed_domains 是白名单,模型的浏览器辅助函数拒绝访问白名单外的地址,主框架导航也会被浏览器本体拦下——但注意官方文档原话:这是给守规矩的模型上的护栏,不是沙箱,页面自己发起的请求并不在过滤范围内。
然后是结构化输出,抓取结果直接落成类型:
from pydantic import BaseModel

class Price(BaseModel):
    item: str
    price: float

r = Agent("查 example.com 的价格", output_model_schema=Price).run_sync()
print(r.structured_output)   # Price(item=..., price=...)
要花钱才能用爽的。默认路径绑定了官方的网关和云浏览器:Agent(task) 不传模型,走的是 bu-4.0(输入 $1.80、输出 $9.00 每百万 token);Browser() 不传参数,起的是官方云浏览器。这里有个官方自己在 release notes 里承认的坑:1.0.6 把默认模型从 bu-fast 换成了 bu-4.0,同样的一个短测试任务,成本从 $0.0014 涨到 $0.022,十五倍。官方的原话是「This costs more if you pass no llm」——话是说明白了,但对不读 release notes 的人,这就是账单刺客。想省钱,要么显式传 llm='bu-fast',要么像我一样接自己的模型。
还只是噱头的。web_search=True 给模型一个联网搜索工具,但要官方 key 才能开;judge(每次跑完让同一个模型给自己的执行过程打分、总结该网站的「gotchas」经验)是新东西,思路不错,可它自己也是一次模型调用,跑高频任务时这笔账不小。云端的 CAPTCHA 自动解决,依赖官方云浏览器,本地版别想。
我是怎么装的
环境:macOS,M2 芯片,Python 3.13。过程本身不复杂,两个坑值得记。
python3 -m venv .venv && source .venv/bin/activate
pip install 'browser-use==1.0.5'
第一个坑是版本号。上面说了,PyPI 上 1.0.6 还没落地,锁 ==1.0.6 会直接报「No matching distribution found」。第二个坑是国内网络:官方 PyPI 源走代理装依赖,十来分钟没动静,换清华镜像三十多秒装完。
装完之后并没有完事。它跑任务还需要一个浏览器内核,走 playwright 的 Chromium,首次会下载 300 多 MB。我把账实际量了一遍:纯库的虚拟环境 188MB,加上浏览器内核,磁盘上总共吃掉 550MB 左右。这个体积不高不低,但别装在满了的系统盘上。
硬件门槛这事,官方 README 没给整机配置表,我直说:没有官方数字,下面是我按依赖体积和实测推的。最低可用档:4 核 CPU、8GB 内存、1GB 磁盘,配一个 4B 级别的小模型(走 API 的话对本地机器几乎没要求,压力全在 API 侧);建议档:8GB 内存起、磁盘留 2GB,模型用 70B 级别或干脆接云端大模型——浏览器任务对模型能力的要求比想象中高,后面细说。
真跑了一遍:2 步,27 秒,答案有点脏
光装不跑等于白装。本机 Ollama 里正好有个 qwen3.5:4b,我就用它配本地 Chromium,跑了个最小任务:打开 example.com,报出页面标题。
from browser_use import Agent, Browser, ChatOpenAI

agent = Agent(
    "Open https://example.com and report the exact page title",
    llm=ChatOpenAI('qwen3.5:4b',
                   base_url='http://localhost:11434/v1',
                   api_key='ollama'),
    browser=Browser('chromium'),
    judge=False,
)
r = await agent.run(max_steps=6, timeout=240)
print(r.final_result())
结果:2 步,27 秒,status: completed,模型确实打开了页面、拿到了标题。但答案是这样的:
{"url": "https://example.com/", "title": "Example Domain", "w": 1200, "h": 1279}
标题是对的——Example Domain。但它是整段页面状态 JSON 直接吐出来的,不是一句人话。4B 的小模型把「完成任务」理解成了「把页面状态交上来」,没做最后的整理。这不是 browser-use 的错,是新引擎把自由度交给了模型之后必然的代价:引擎管到「跑通」,不管「答得漂亮」。换个大一点的模型或者加一句任务描述里的输出格式要求,能解决大半,但你要有预期——浏览器任务对模型能力的下限,比你想象的高。
还有几处跑的时候才注意到的细节,一并记下。我给了 max_steps=6 和 timeout=240 两个上限——1.0 的默认步数从 0.x 的 500 降到了 100,一步就是一次模型请求,这个默认值对以「步」计费的模式来说是负责任的做法,但跑长任务前要自己心里有数。跑完之后本地留下了一个 browser-use- 开头的临时目录,里面存着页面文本、截图和每一步的输出,官方文档建议用完删掉或者传自己的 workspace= 路径接管。另外跑之前记得设 BROWSER_USE_AUTO_LOGIN=false,否则在没有 key 的情况下它会弹官方登录窗口——服务器和 CI 环境不会触发弹窗,但我这种桌面环境必须显式关掉,不然一个最小验证脚本都能把登录页拉出来。
另外两个顺手捞到的观察。一是不传模型直接 run_sync(),会抛 MissingAPIKeyError,错误信息把三条出路(去官网拿 key、跑 browser-use login、本地模型加本地浏览器的写法)写得清清楚楚,这种报错质量值得点名表扬。二是跑完之后控制台刷了一行怪东西:telemetry 的临时文件清理走了 macOS 的废纸篓 API,报了个 FSMoveObjectToTrashSync failed (status -43)。无害,但说明它连删临时文件都想给你留后悔药,风格如此。不想要遥测的话,ANONYMIZED_TELEMETRY=false 一个环境变量的事。
别人踩过的坑,我逐条对过
issue 区我翻了一遍,170 个纯 issue 开着,高频的这几条都有代表性:
- 截图污染上下文(#4742,16 条评论):工具返回里带截图 blob,会把后续所有轮次的对话搞挂,直接 API 400。长任务跑一半突然全崩,先查这个。
- CDP 连接不稳定导致无限悬挂(#4579):配远程浏览器时连接断了不报错,任务干挂着。第三方第三方的讨论里也有「无限循环」「卡在 about:blank」的反馈,是这个问题的近亲。
- 页面崩溃不自动恢复(#5067):标签页崩了之后智能体原地挂起,没有恢复机制。跑无人值守的批处理要自己包一层看门狗。
- 已知答案误报成功(#6031):维护者自己开的回归案例集,列了 403 拦截、点击被禁用等六种「看起来跑完了其实没成」的场景。这条最值得警惕——不要把「run 正常结束」当成「任务成功」,结果要拿已知答案验。
==锁版太严引发依赖冲突(#4824):官方让你锁==,但放进一个大项目里,依赖树冲突的概率不低。两难,官方目前选了保守的那边。- 要求恢复
pause()(#4798,20 条评论,是纯 issue 里最热的):1.0 砍掉了任务中途暂停,想在工具调用里插入人工确认的开发者只能用取消加重跑凑合。人机协同这块,1.0 反而比 0.x 退了一步。
第三方的讨论我搜了中英文两边。中文圈一篇流传较广的文章(toolnavs)把账目结构讲得很透:一步就是一次模型调用,一个「去几个网站比价再填张表」的任务轻松跑出二三十步,旗舰模型下单次任务的 API 费能高出一个数量级。英文侧一份第三方测评(aitoolbox.hk)吐槽的几条我印象很深:SPA 单页应用是大敌,内容渐进加载、元素动画位移会让它点空;报错是开发者级的 Python 栈,不是人话;云服务文档跟实际有出入(宣传 10 并发,默认给 3)。还有一位博主实测让智能体自动投 GitHub 职位,它把「Remote」点成了「Hybrid」——错误看起来离谱,但这恰恰是这类工具的常态。
安全这块单独说。官方迁移文档里有一节「Trust model for secrets」,写得非常坦诚:sensitive_data 不是沙箱,模型写的 Python 能读到值;本地调试端口开在 127.0.0.1 且无鉴权,共享机器上其他本地用户可以连上你的浏览器;云浏览器的 live view 链接,谁拿到谁能控制。学术圈那篇 The Hidden Dangers of Browsing AI Agents 也是拿 browser-use 早期实现做的演示。结论很简单:跑不信任的任务,放容器里;allowed_domains 是给守规矩的模型上的护栏,不是给你上的保险。
我的判断
值不值得上手,我的答案是分情况的。
值得:你要自动化的是「页面结构天天变、自己不掌控」的第三方网站,任务是多步的、每次路径不完全一样;你有 Python 基础,读得动报错;任务失败了可以重来,或者你能接受 3% 到 8% 的点错率(第三方对比文给的数字,我自己的小样本没测出这么高的错误率,但方向上认同——别拿它做下单这种错了没法撤的事)。
不值得:页面是你自己的、路径固定的高频自动化——直接写 Playwright,快一到两个数量级,模型费为零;要跑银行、政务这类强验证码网站——本地版会卡死,云版也要碰运气;想无人值守跑关键业务——先解决上面 #5067 和 #6031 两个问题再说。
替代方案点名两个。第一个是 Playwright(配它自己的 MCP 服务器):路径确定、点击 10 毫秒级、零 API 费,代价是页面一改版选择器就断,维护成本全在你这边。对比维度就一条:页面变不变。变,用 browser-use;不变,用 Playwright。第二个是 Stagehand(browserbase 家的):定位在中间——大部分步骤写死、只把那一两次「点哪个、抓什么」交给自然语言,act 和 extract 两个原语够用。如果你的工作流里 90% 是确定性脚本、只有几步需要理解页面,Stagehand 比 browser-use 更省 token。
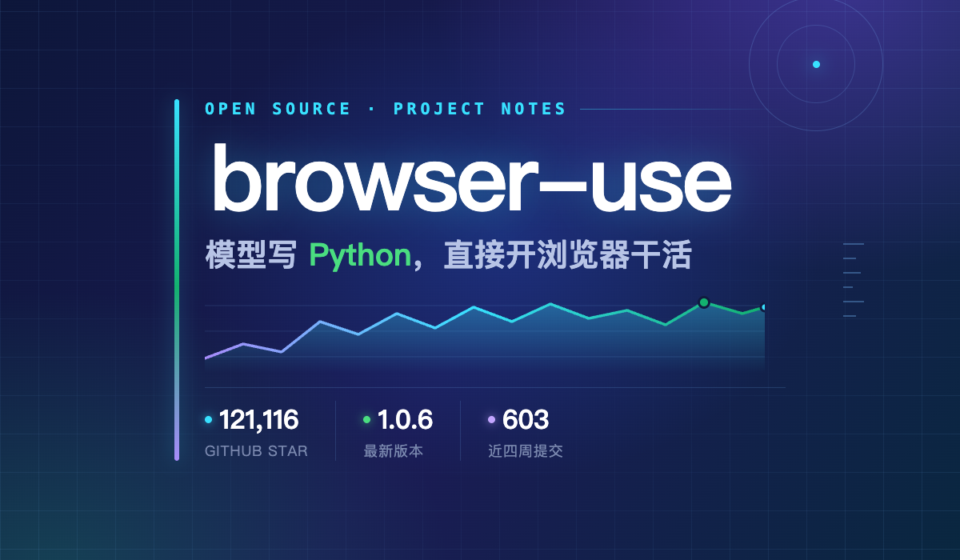
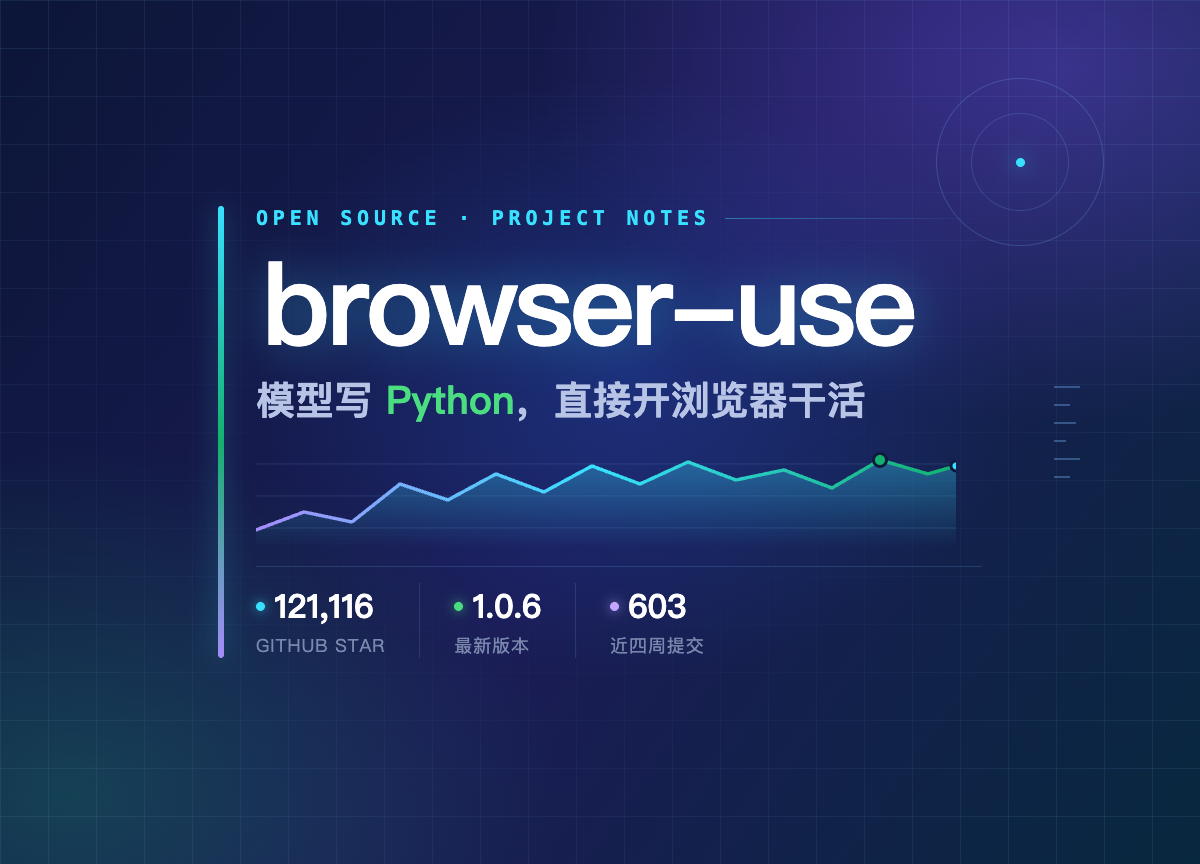
总而言之,browser-use 这次换代我给正面评价:REPL 加 CDP 的执行模型把「智能体操作网页」从挑菜单变成了写代码,上限高了一截,旧接口的兼容处理也算体面。代价是生态断层——你收藏夹里那批教程,从今天起当历史资料看吧。顺手拉了下实时数据,现在是 121,116 个 star,MIT 协议,最近四周 603 次提交,open issue 170 个,三天连发三个版本。项目还在高速移动中,跟车请系好安全带,锁好版本号。
最后说句实在的,我没有 N 卡、也没买它的云服务,上面的结论全部来自本地 4B 小模型的真跑和官方文档的逐段核对——连它 PyPI 上 1.0.6 还没同步这种事,都是装的时候撞见的。这种「高速迭代中的半成品感」是它最真实的味道:能跑通的时候惊喜,崩的时候猝不及防。拿它先做只读的小任务练手,别一上来就交钥匙。