
那行报错我现在还记得:TypeError: (0 , _middleware__WEBPACK_IMPORTED_MODULE_2__.default) is not a function。
不是报错本身难,是它出现的位置太顺理成章了——我把需求说清楚,模型给了我一整套 middleware.ts,写法漂亮,注释齐全,matcher 也配好了。我甚至没细看就存了盘。跑起来之后才反应过来:我用的这个版本里,这个文件约定已经改名了,模型给我的是两年前那一套。
更烦的是我当场就知道怎么办——去翻官方文档,抄最新写法。翻完贴进对话框,它懂了,改对了。然后过了四十多轮对话,上下文被挤掉一部分,它又开始按老写法给我补代码。
两年前那套写法,是怎么一直跟着我的
我做企业侧的后台系统,前端后端都碰。这类项目的依赖有个特点:不算新,但一直跟着升。一个库从 v14 跳到 v16,配置文件的位置、导出的函数名、甚至目录约定都可能挪一遍。这些变化在官方文档里写着,写得很清楚,问题在于模型的知识是冻住的,我的依赖不是。
我试过的办法,按时间排:
第一条,手动贴文档。 直接把 docs 页面复制进对话。能用,但很笨。一个页面三四千字,贴两页上下文就满了,而我要的可能只是其中一段 matcher 的配置说明。贴完这一轮有效,下一轮它又忘了,因为早期内容被压缩掉了。
第二条,让它联网搜。 搜回来的是一堆 HTML 和导航栏,真正有用的两行夹在中间。而且搜出来的版本对不对,还得我自己判断——有一次它搜到的是 v12 的博客,比模型自带的记忆还旧。
第三条,自己写规则文件。 我在项目里放了个说明文件,写「本项目用 Next.js 16,配置文件叫 proxy,不是 middleware」。这条最有效,但也最累:每升一次依赖我就得去改一遍,改的时候还得先自己弄明白新版到底怎么写的。等于我在给模型当人肉索引。
第三条我用了小半年。它的本质是——我在维护一份只给模型看的、随时会过期的文档副本。这事儿一想就很别扭。
后来是在一个同行的编辑器配置里看到一行 URL:https://mcp.context7.com/mcp。他说这玩意儿能自己去找文档。我当时的第一反应是又一个套壳搜索,没当回事。真正让我回头去翻它的,是另一次更尴尬的翻车:我给一个刚毕业的同事讲某个库的用法,讲的是旧写法,他照着写完跑不通,回头问我,我才发现自己脑子里那份文档也过期了。
行吧,那就装。
它实际就两个工具,窄得有点意外
先说结论:这东西的功能面比我预期的小得多,小到有点意外。
我把远程端点接上之后列了一下工具清单,返回的就两个:
resolve-library-id   查库,把「next.js」这种名字换成一个库 ID
query-docs           按库 ID 拉文档片段
就这两个。没有搜索、没有摘要、没有代码生成、没有仓库读取能力。它干的事只有一件:把某个库某个版本的文档,按我的问题裁一段出来,交给模型。
我实际打了一次 resolve-library-id,参数是库名加一句我要干的事:
{
  "name": "resolve-library-id",
  "arguments": {
    "libraryName": "next.js",
    "query": "how to configure a proxy middleware that checks a JWT cookie"
  }
}
回来的东西比我预想的厚。除了库 ID /vercel/next.js,还带了几个我没想到的字段:
- Title: Next.js
- Context7-compatible library ID: /vercel/next.js
- Code Snippets: 6160
- Source Reputation: High
- Benchmark Score: 78.49
- Versions: v14.3.0-canary.87, v13.5.11, v15.1.8, v16.0.3, v16.1.0, v16.2.9 ...
Code Snippets: 6160 是它给这个库攒了多少段可检索代码;Versions 是它手上真有的版本号列表,我数了下这次返回了十五个。这个列表是它敢说自己「版本对齐」的底气:我要是问 v16 的写法,它能把 v16 那一支的文档捞出来,而不是笼统给个「Next.js 通用写法」。
同一次调用它还顺手给了四个相近的库:/websites/nextjs、/ixartz/next-js-boilerplate、/auth0/nextjs-auth0、/workos/authkit-nextjs,每个都带独立的 snippet 数和 benchmark 分。这个设计我觉得挺聪明——库名撞车太常见了,next.js 和 nextjs-auth0 完全是两回事,让模型自己在候选里挑,比硬猜一个强。
真能用的三件事
第一,版本对齐是真的。 我用 /vercel/next.js 问了一句 proxy 里怎么校验 cookie 里的 JWT,回来的文档开头就在讲 Proxy 这个文件约定,还特意提了一句 Proxy 跑在 Node.js runtime 上、注意鉴权库兼容性。这正是我上半年踩的那个坑——如果当时有这么一段,我不至于写出那个 middleware.ts。
第二,库 ID 可以直达。 知道库了就别让模型猜,直接写死在提示里:
用 /vercel/next.js 的文档,写一个校验 cookie 里 JWT 的 proxy 配置
省掉一次匹配。文档里管这个叫 slash 语法,我试过,确实跳过了挑库那一步。
第三,查不到会明确告诉你查不到。 我拿一个不存在的库 ID 试了下:
{"name":"query-docs","arguments":{"libraryId":"/mycompany/internal-sdk","query":"auth"}}
返回 isError: true,正文是 Library "/mycompany/internal-sdk" not found. Please check the library ID or your access permissions.。注意后半句——它连「权限」都提示了,说明白了这个东西对私有库是不设通道的。这个诚实挺好,比返回一段看起来像模像样的编造内容强一百倍。
剩下的部分,宣传语要打折
README 里的对照表写得很带感:不用它,你会拿到过时代码、不存在的 API、老版本的答案;用了它,一切解决。这话对一半。
「消灭幻觉」这个说法我不同意。它降低的是「文档过期」这一类错误,模型自己逻辑写错、把我业务理解错,它一点忙都帮不上。项目里现在还有一个 open 的 issue(#3384),标题大意是某个示例在 SDK 更新之后仍然是错的——连它自己索引的内容都会滞后,指望它兜住所有错不现实。
「token 高效」也得打个折。我实际量了一次:问一句 proxy 校验 JWT,query-docs 返回了 9,785 个字符的正文。按英文一 token 约四字符粗算,这一次就是两千多 token 灌进上下文。它确实比整页文档少,但绝不是「一点点」。省 token 的前提是我把问题问窄,问得越糊,回来的越多。
薄客户端、闭源后端,这笔账得算清楚
这是我对它最有保留的地方,也是我劝人别急着上的一条。
README 末尾第二条免责声明写得很直白:这个仓库只放 MCP 服务端的源码,API 后端、解析引擎、爬取引擎都是私有的,不在这个仓库里。我对着这个仓库翻了翻,确实如此——TypeScript 写的是一层协议适配和请求转发,真正决定「哪个库、哪段文档、怎么排序」的那套东西,一行都看不到。
所以它不是一个能自己搭起来的东西。MIT 协议是真的,但 MIT 只覆盖了那层薄壳。我把它当成「一个免费的托管服务 + 一个开源的接入层」来看,心态就顺了。
这个架构带来的代价,有三条我觉得必须摆出来:
查询内容会出网。 query 这个参数就是我的问题描述,它会被发到对方的服务端。所以我给自己定了条规矩:查询里只写库名和通用技术描述,绝不带客户名、内部模块名、字段名。做私有化交付的同行尤其要注意这点,一句「我们 CRM 的客户表怎么关联」就已经把业务结构送出去了。
内部库完全无解。 上面那个 isError 已经证明了:库里没有的东西,它不会给你。公司内部 SDK、私有组件库、内网 API 文档,这条路走不通,还是得回到手动喂文档或者让模型读源码。
信任成本转移到了别人身上。 文档是社区投稿的,团队自己也承认「不能保证准确性、完整性、安全性」。这句话我在两个地方同时看到——README 的免责声明,和返回内容里夹的第三方文本。所以文档片段进上下文这件事,本质上跟任何一个外部工具返回值一样,都是不可信输入。
还有一笔开销是常驻的,容易被忽略:工具描述本身要占上下文。我实测把两个工具的完整 schema 序列化出来是 5,289 个字符,其中一个 resolve-library-id 的描述就有 2,006 个字符——它把「选库流程」「返回格式」「注意事项」全塞进 description 里了。社区有人拿这个开刀,说这是把用户手册写进了 schema 字段,给整个服务打了不及格分(dev.to 上那篇 “The #1 Most Popular MCP Server Gets an F”)。我实测的字符数和它说的对得上。
我的判断是:这笔开销单独看不算事,两个工具、五千字符,比大部分服务轻。但不能叠。 编辑器里挂着七八个 MCP 服务、每个都塞几千字符 schema 的话,光开机就吃掉小半上下文——那边有开发者报过工具定义占掉上下文四成的情况。真想省,就别一次装一堆。
装起来十分钟,卡住我的不是安装
安装这件事我过得挺顺,因为门槛根本不在安装步骤上。
官方给的是一条命令:
npx ctx7 setup
它要求 Node.js 22.13 或更新。我本机是 v22.22.2,直接过了。这一步会走 OAuth、生成 API key、装上对应的规则文件,中间会让我选模式:CLI + Skills,还是 MCP。也能直接指定目标编辑器:
npx ctx7 setup --cursor
npx ctx7 setup --claude
npx ctx7 setup --opencode
要卸掉用 npx ctx7 remove。如果是全局装的 CLI,那个包得单独 npm uninstall -g ctx7 卸——这点 README 特意提了,估计是有人卸不干净来问过。
不想用一条命令的话,手动配也行,远程端点是:
{
  "mcpServers": {
    "context7": {
      "url": "https://mcp.context7.com/mcp",
      "headers": {
        "Authorization": "Bearer 你的_API_KEY"
      }
    }
  }
}
或者走 stdio 起本地进程:
npx -y @upstash/context7-mcp --api-key 你的_API_KEY
硬件要求这块,官方没写。 我不替它编。它不跑模型、不需要显存,所以真正卡人的只有三样:Node 版本、能出网、API key 有没有。我给两档,都很土:
- 最低能用:Node 22.13+,不配 key 直接匿名用,代价是限流紧,问几句就容易被挡。
- 建议配置:还是 Node 22.13+,去官网后台领个免费 key。第三方整理的文章里提到免费额度在 2026 年 1 月从大约 6,000 次/月砍到了 1,000 次/月,这个数字我没在官方页面亲自核到,只能当参考。个人一天问十来次,1,000 次/月够。
真正卡住我的地方在装完之后。它默认不会自己动——我不在提示里带触发词,模型压根不会去调它。要么每次加 use context7,要么把 setup 装的那份规则文件留着,让它在遇到库相关问题时自动去查。我第一次装完没反应,就是这个原因,还以为是配置写错了。
从 ping 到一次真实检索,我把整条路走了一遍
这部分我不用二手描述,全是我自己打出来的。
先确认服务活着:
curl -s https://mcp.context7.com/ping
# {"status":"ok","message":"pong"}
然后按 MCP 的规矩握手,一个 POST 就够:
curl -s -X POST https://mcp.context7.com/mcp \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{
        "protocolVersion":"2025-06-18","capabilities":{},
        "clientInfo":{"name":"curl-probe","version":"0.0.1"}}}'
回来的是一段 SSE,data: 后面才是正文。有用的几个字段:
protocolVersion: 2025-06-18
serverInfo: {"name":"Context7","version":"4.4.3"}
capabilities: tools / prompts / resources 都有,均 listChanged=false
有个细节值得记一下:服务端报的版本是 4.4.3,而 npm 上 @upstash/context7-mcp 已经是 4.4.4 了。 部署比发包慢一个补丁版本,这种小错位在托管服务里很常见,但说明「线上跑的东西」和「我装的东西」不一定同版本。另外整个握手没给我 session id,是无状态的,这点对手写探测挺友好。
接下来列工具、量体积:
tools: 2
schema 总字符: 5,289
  resolve-library-id  desc 2,006  schema   813
  query-docs          desc   547  schema 1,461
再往下就是我前面贴过的那次 resolve-library-id 和一次 query-docs。整条链路走完,我大概用了不到五分钟,中间没遇到鉴权问题——因为我是匿名打的,没带 key。

顺手还核了几个包名,因为网上流传的名字有一半是错的:
| 包名 | 实际情况 |
|---|---|
ctx7 |
存在,0.8.2 |
@upstash/context7-mcp |
存在,4.4.4 |
@context7/mcp |
不存在 |
context7-mcp |
不存在 |
后两个我问了 npm,都报错。写着「照着装就行」的老文章,抄的多半是这两个错名字。
别人踩过的坑,比 README 有用得多
我翻 issue 的时候先看了眼总量,这个数字比 star 更有说服力:已关闭 2,424 条,还开着 23 条。开了两千多条还能收到这个比例,维护是真的在跟。
高频问题集中在这几类,我都附上链接,方便自己回头查:
- #716(24 条讨论):报「Unauthorized. Please check your API key.」,但 key 怎么换都是好的。这类鉴权坑最容易劝退人,尤其是配在别人的配置文件里、报错又不告诉你哪一步错了的时候。
- #658(27 条):Codex 里报
MCP client for context7 failed to start: program not found。命令名或包名写错就会这样,跟我上面核出来的那两个 404 包名是同一个病根。 - #829(22 条):Windsurf 里用 npx 挂本地服务,把整个 MCP 配置搞成刷新死循环,连带别的服务一起挂。一条配置写错能把一屋子服务拖下水,这也是我现在更愿意用远程端点、少起本地进程的原因。
- #738(30 条):编辑器某个版本之后连不上远程 MCP。这类问题基本无解,只能等客户端修。
- #339(98 条,至今 open):库重复、冗余,喊社区一起清理。这是社区投稿模式的必然结果——我上面看到
next.js和nextjs两个 ID 并存,就是这条 issue 的现场。 - #214(open):有人求官方出 Docker 镜像,一直没出。回头看我前面那句「不可自托管」,这条 issue 就是旁证。
- #3384(2026 年 10 月新开):示例在 SDK 更新后仍然不对。文档索引也会过期,别把它当权威。
外部讨论我也扫了一圈,有几条比 issue 更扎心:
社区里有个专门给 MCP 服务打分的项目,把它排在了倒数——两个工具、1,020 token、7.5 分。同一批人里另有人认为它的上下文成本「可以忽略」。这两拨人其实没矛盾:绝对值看它确实轻,问题是它把用户手册写进了 schema。我倾向后者的结论、前者的做法——留着,但别再多装。
中文圈里被提得最多的坑是「装好了它不查」。原因很简单:不显式触发,也没有规则文件,模型就按自己记忆答。这一点在 奇连那篇实操笔记 里也写了同样的现象,看来不是我一个人犯傻。
还有个坑挺隐蔽,developertoolkit 的整理 里提到:Codex 的 config.toml 里写 headers = {...} 会被静默忽略,服务照跑,但没带上 key,于是限流或者 401 找上门。静默失败最难查。同一篇里还说 claude mcp add -e KEY=value context7 ... 这种写法参数顺序错了会失败,得把服务名放前面。
最后我怎么定的
留下,但改了用法。
我留下它的理由只有一个:它把「我去翻文档再贴给模型」这件事自动化了,而且版本对得上。我一天里最烦的重复劳动就是这个,谁替我干我都欢迎。装上之后我把项目里那份自己维护的规则文件删了——那东西每升一次依赖就得手改,纯属给模型打补丁。
用法上我收了三处:只用远程端点,不起本地进程,少一个炸点;查询句式固定成「库名 + 我要干什么」,不写业务上下文;一个项目里最多挂三个 MCP 服务,超了就砍。
不适合的,我也说清楚:以内部库、私有组件为主的项目,它帮不上,别浪费时间;合规卡得紧、代码和需求一个字都不能出网的场景,直接排除,没有商量余地;上下文预算本来就吃紧、已经挂了五六个服务的,再加它只会更挤。
要对比的话,我拿两个东西跟它比:
GitMCP,思路完全相反——把任意一个 GitHub 仓库直接变成文档源,改个域名就能用,零配置。维度差别在覆盖面:GitMCP 只认 GitHub 上有的仓库,胜在不用投稿、什么冷门库都能查;Context7 胜在有人工整理和版本切片,返回的东西更像「给人看的文档」而不是「仓库里的 md」。我要查的是主流框架,选后者;要查的是某个小众仓库,前者更快。
Serena,走的是另一条路——不查文档,直接对代码做符号级索引,能跳转、能改名、能重构。维度差别在问题类型:我问「这个库怎么用」,Serena 答不了;我问「这个函数在这个仓库里被谁调用」,Context7 答不了。两个不是替代关系,是补位关系。
一句话:它治的是「模型不知道新写法」,不治「模型想不清楚」。 前者我天天遇到,后者还得靠自己。
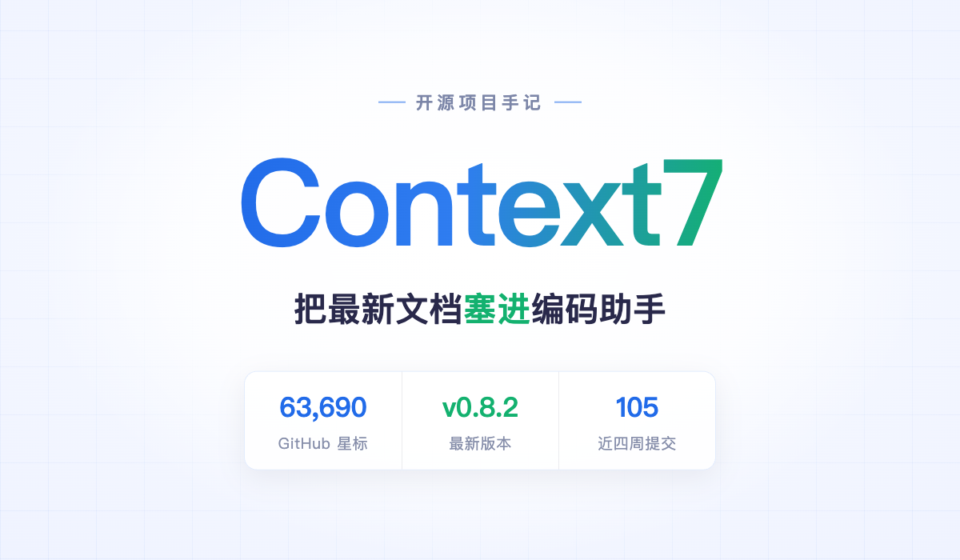
总而言之,这东西不是银弹,但它把我最烦的那段重复劳动拿走了,而且拿得挺干净。顺手看了下仓库,现在是 63,690 个 star、3,140 个 fork,最近四周 105 次提交,最新发的版本是 ctx7@0.8.2(10 月 23 日),配套的 context7-mcp 到 4.4.4 了。一个两千多条 issue 关掉、只剩二十几条开着的项目,我敢让它进我的日常工具链。
最后说句实在的,装之前我只问自己一句:「我在查哪个库、要干什么」这句话,我愿不愿意发到别人的服务器上? 愿意就装,不愿意就去用 GitMCP,各有各的活法,没必要争。